Wie KI Clip Maker YouTube-Videos schneiden, reframen und untertiteln
Erfahren Sie, wie ein KI Clip Maker für YouTube Transkripte analysiert, Sprecher verfolgt, ins 9:16-Format reframed und wortsynchrone Untertitel generiert.
Aktualisiert am Von ClipFlap editorial team
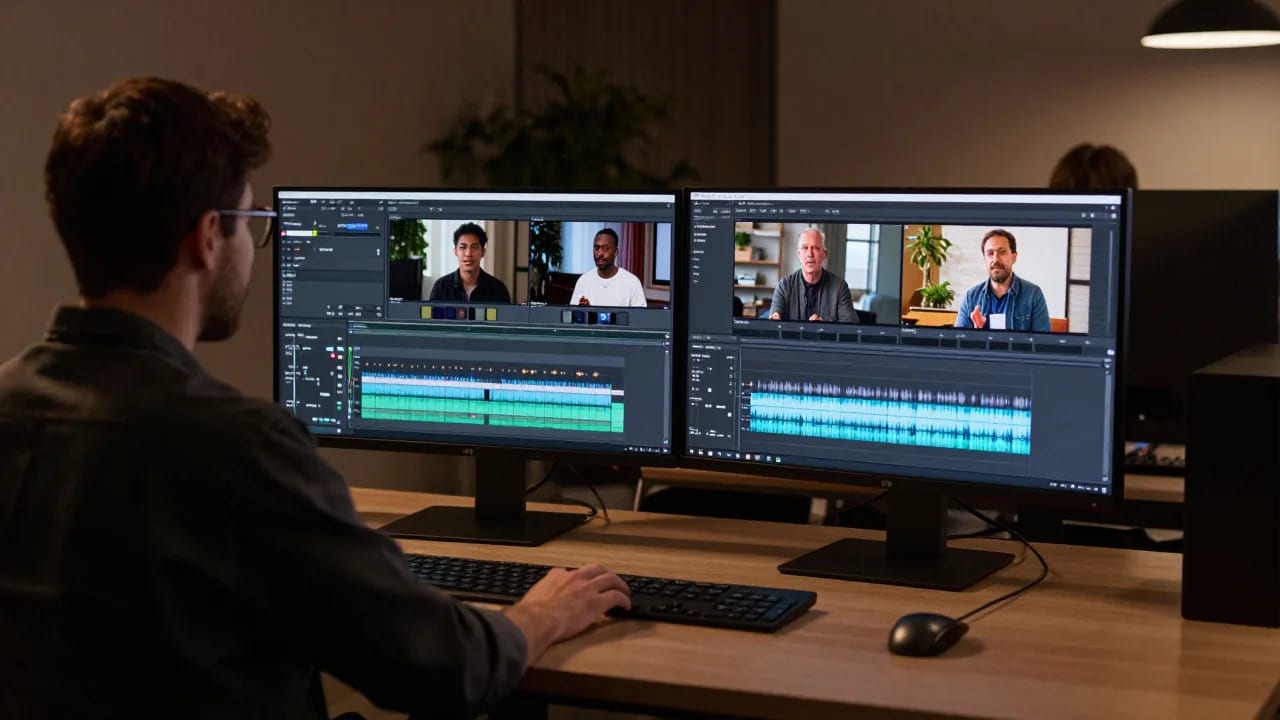
Das Umwandeln von Long-Form-Videos in vertikale Shorts ist heute ein elementarer Bestandteil moderner Content-Distribution. Doch mehrstündige Timelines manuell nach passenden Momenten zu durchsuchen, kostet enorm viel Zeit und Konzentration. Ein KI Clip Maker für YouTube beschleunigt diesen Workflow erheblich, indem er aufgezeichnete Interviews, Podcasts und Vorträge in strukturierte Kurzclips zerlegt. Statt auf reines Raten zu setzen, kombinieren diese Systeme automatische Transkription, visuelle Sprecherverfolgung und Akustikanalyse, um in sich geschlossene Kernaussagen präzise zu identifizieren.
Zu verstehen, wie diese Pipeline im Detail funktioniert, hilft Video-Editoren, Podcastern und Content-Teams realistisch einzuschätzen, was automatisierte Tools leisten können – und an welchen Stellen menschliches redaktionelles Urteilsvermögen weiterhin unerlässlich bleibt.
Die mehrstufige Pipeline: Wie KI Long-Form-Content von YouTube erfasst und parst
Der Übergang von einem horizontalen YouTube-Video zu einem vertikalen Clip ist kein einfacher Rechenschritt. Dahinter steht eine Kette spezialisierter Machine-Learning-Modelle, die parallel Audio- und Videodaten auswerten.
Sobald eine Videodatei hochgeladen oder ein YouTube-Link importiert wird, trennt das System die Datei in separate Audio- und Videospuren:
- Audio-Demuxing: Die Tonspur wird isoliert und normalisiert, um Störgeräusche zu minimieren und Sprachsignale hervorzuheben.
- Speech-to-Text-Transkription: Ein Spracherkennungsmodell wandelt das gesprochene Wort in einen mit Zeitstempeln versehenen Textstrom um – oft auf die Millisekunde genau.
- Analyse der Wellenform: Lautstärkepegel, Sprechpausen, Tonhöhenverläufe und plötzliche akustische Spitzen werden parallel zum Transkript indexiert.
- Computer-Vision-Decodierung: Die Videospur wird analysiert, um Szenenwechsel, Kameraschnitte und Gesichtsmerkmale (Landmarks) zu erfassen.
Sobald diese Datenebenen synchronisiert sind, kann ein KI-Video-Clipping-Tool beginnen, das Rohmaterial nach narrativen Strukturen zu durchsuchen, anstatt es nur als statische Bildpunkte zu verarbeiten.
Transkriptbasierte Analyse: Wie Algorithmen Hooks und Spannungsbögen erkennen
Einen verwertbaren Kurzclip zu finden, erfordert mehr als das bloße Erkennen lauter oder energiegeladener Passagen; entscheidend ist eine in sich geschlossene narrative Einheit. Längere Gespräche enthalten naturgemäß thematische Abschweifungen, Querverweise und unvollendete Gedanken, die isoliert im Social-Media-Feed schnell unvollständig wirken.
Erkennung semantischer Sinnabschnitte
Mithilfe von Natural Language Processing (NLP) analysiert das System den Text, um herauszufinden, wo ein Gedankengang beginnt und wo er endet. Der Algorithmus gruppiert Sätze zu thematischen Clustern, indem er die semantische Ähnlichkeit aufeinanderfolgender Phrasen berechnet. Verändert sich das Thema signifikant, setzt das System eine Grenzmarkierung.
Identifikation von Einstiegshooks und Pointen
Damit die automatische Highlight-Erkennung tragfähige Segmente liefert, bewertet der Algorithmus Kandidaten nach narrativer Kohärenz:
- Der Opening Hook: Algorithmen scannen den Beginn eines Segments nach pointierten Thesen, provokanten Fragen oder prägnanten thematischen Einstiegen.
- Syntaktische Vollständigkeit: Aussagen, die stark auf unaufgelöste Pronomen oder vorherige Kontextbezüge angewiesen sind (wie „wie wir vorhin schon sagten“), erhalten schlechtere Standalone-Werte.
- Der Höhepunkt oder die Pointe: Das Modell sucht nach inhaltlichen Zusammenfassungen, Erkenntnissen oder Pointen. Diese werden oft durch akustische Merkmale wie Lachen oder markante Betonungen validiert.
Durch diesen transkriptbasierten Videoschnitt identifiziert die Software potenzielle Clips mit einer Länge von 30 bis 90 Sekunden, die eine eigenständige Logik besitzen, ohne Vorwissen beim Zuschauer vorauszusetzen.
Computer Vision und Reframing: Horizontales Material ins 9:16-Format bringen
Die meisten YouTube-Inhalte werden im horizontalen 16:9-Format produziert. Die Umwandlung in ein vertikales Videoformat verlangt intelligentes Reframing. Ein simples, statisches Zuschneiden auf die Bildmitte führt häufig dazu, dass aktive Sprecher abgeschnitten werden.
Gesichtserkennung und Sprecher-Diarisierung
Um die Kameraführung dynamisch auf den Sprechenden auszurichten, kombiniert die Software visuelle Gesichtserkennung mit Audio-Diarisierung. Die Diarisierung trennt die Tonspur nach unterschiedlichen Sprecherprofilen auf Basis von Stimmfrequenzen. Spricht Sprecher A, lokalisiert das Computer-Vision-Modell die entsprechende Bounding-Box im Bild und zentriert die virtuelle Kamera auf dessen Gesicht.
Dynamische Bewegungsverfolgung und Glättung
Bewegt sich eine Person im Raum oder gestikuliert sie stark, verfolgt das System diese Koordinaten über aufeinanderfolgende Frames hinweg. Um ruckartige, unnatürliche Kamerasprünge zu vermeiden, berechnen mathematische Glättungsfunktionen weiche Schwenks, die der Führung eines erfahrenen Kameraoperators ähneln.
Mehrpersonen-Layouts
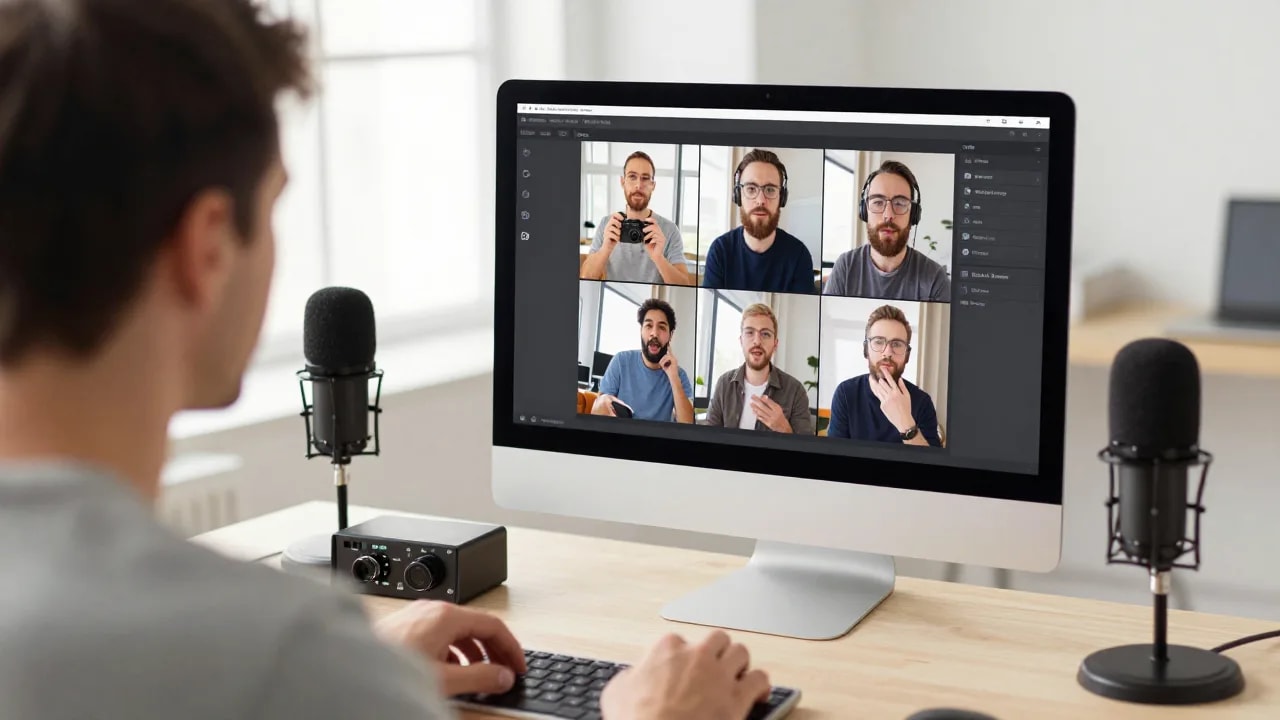
Bei Interviews oder Gesprächsrunden mit mehreren Gästen greifen einfache Schwenks oft zu kurz. Viele Editoren setzen hier auf einen Podcast-zu-Clips-Workflow, der dynamisch zwischen Split-Screen-Layouts (bei denen Host und Gast übereinander dargestellt werden) und fokussierten Nahaufnahmen wechselt – abhängig von Gesprächsdynamik und Sprecherwechseln.
Wortsynchrone Untertitel: Phonem-Abgleich und visuelle Typografie
Untertitel sind für vertikale Feeds unverzichtbar, da ein großer Teil der Nutzer Videos ohne Ton konsumiert. Herkömmliche Untertitelblöcke mit zwei statischen Zeilen am unteren Bildrand werden auf Plattformen wie TikTok oder YouTube Shorts zunehmend durch dynamische, kinetische Untertitel ersetzt.
Akustisches Forced Alignment
Um Untertitel wortgenau zu timen, nutzt die KI das sogenannte Forced Alignment. Die Spracherkennungs-Engine zerlegt Wörter in ihre kleinsten Lauteinheiten (Phoneme) und ordnet diese den exakten Millisekunden-Markern in der Wellenform zu. Dadurch erscheint jedes Wort auf dem Bildschirm exakt in dem Moment, in dem es ausgesprochen wird.
Typografische Gestaltung und Safe Zones
Sobald das Timing steht, übernimmt die Rendering-Engine die visuelle Aufbereitung:
- Kompakte Textblöcke: Es werden meist nur ein bis drei Wörter gleichzeitig eingeblendet, um die Lesbarkeit und das Sehtempo hochzuhalten.
- Farbliche Hervorhebung: Das aktuell gesprochene Wort wird farblich oder durch Skalierungseffekte akzentuiert.
- Berücksichtigung von Safe Zones: Untertitel werden so platziert, dass sie nicht von Interface-Elementen der Plattformen wie Benutzername, Like-Buttons oder Kommentarfeldern verdeckt werden.
Technische Grenzen: Wo automatisierte Momentauswahl an Grenzen stößt
Obwohl Machine-Learning-Modelle enorme Datenmengen schnell filtern können, verfügen sie über kein echtes Textverständnis. Wer sich blind auf vollständige Automatisierung verlässt, stößt schnell auf typische Fehlerquellen:
- Fehlender Kontext: Ein Algorithmus wählt möglicherweise eine starke Aussage aus, schneidet jedoch einen entscheidenden Relativsatz oder Vorbehalt direkt davor ab.
- Ironie und Sarkasmus: NLP-Modelle tun sich schwer mit trockenem Humor oder ironischen Bemerkungen und werten satirische Kommentare mitunter fälschlicherweise als sachliche Kernbotschaften.
- Stimmüberschneidungen (Crosstalk): Wenn mehrere Personen durcheinanderreden und keine getrennten Mikrofone genutzt wurden, verliert das Sprecher-Tracking mitunter die Orientierung, was zu hektischen Kamerasprüngen führen kann.
- Falsch interpretierte Pausen: Eine bewusste Kunstpause zur Spannungssteigerung wird von Schwellenwerten für Stille mitunter als Leerlauf gewertet, was zu unnatürlichen Schnitten mitten im Satz führt.
Diese systemimmanenten Limitationen verdeutlichen, warum ein algorithmischer Entwurf als fundierte Rohfassung dienen sollte und nicht als unkorrigiertes Endprodukt.
Human-in-the-Loop-Review: Den KI-Entwurf vor dem Export finalisieren
Um aus einem automatisierten Vorschlag einen reichweitenstarken Short zu machen, ist ein kurzer redaktioneller Kontrollblick unerlässlich. Durch das Zusammenspiel aus algorithmischer Vorarbeit und menschlicher Qualitätskontrolle sparen Content-Teams Zeit, ohne Abstriche bei der inhaltlichen Präzision machen zu müssen.
Checkliste vor der Veröffentlichung
Bevor ein Clip für YouTube Shorts exportiert wird, sollten folgende Aspekte kurz überprüft werden:
- Kontextprüfung: Funktioniert der Ausschnitt auch für jemanden, der den Kanal oder das Gesamtvortragsvideo nicht kennt?
- Schnittgrenzen kontrollieren: Reicht der Clip-Anfang oder das Ende aus, oder wurde ein Atemzug oder ein Verbindungswort unsauber abgeschnitten? (Ggf. 1–2 Sekunden Puffer ergänzen).
- Kamerazentrierung: Sitzt das Gesicht im 9:16-Ausschnitt durchgehend stabil, ohne dass Gesten zu hektischen Bildbewegungen geführt haben?
- Fachbegriffe und Eigennamen: Wurden Markennamen, Fachjargon oder Dialektausdrücke im Transkript fehlerfrei erkannt und korrekt geschrieben?
Moderne Plattformen wie ClipFlap ermöglichen es, transkriptbasierte Highlight-Erkennung, automatisches Reframing und wortsynchrone Untertitel zu nutzen, während Editoren stets die volle Kontrolle über Timeline, Typografie und Bildausschnitte behalten.
Häufig gestellte Fragen (FAQ)
Wie erkennt ein KI Clip Maker, welche Szenen eines YouTube-Videos relevant sind?
KI-Tools analysieren Videos, indem sie das Speech-to-Text-Transkript mit Audiopegeln und Bilddaten abgleichen. NLP-Modelle erkennen thematische Abschnitte, Einstiegshooks und Kernaussagen, während Akustikmodelle Lautstärkeänderungen, Sprechtempo oder Lachen erfassen, um in sich stimmige Ausschnitte zu identifizieren.
Warum sind wortsynchrone Untertitel für Kurzclips besser als klassische Untertitel?
Wortsynchrone Untertitel blenden Wörter exakt im Moment des Sprechens dynamisch ein und heben sie farblich hervor. Das steigert die visuelle Dynamik, lenkt den Blick ins Zentrum des Hochformats und ermöglicht barrierefreies Schauen ohne Ton, ohne das Bild mit unübersichtlichen Textblöcken zu überladen.
Kann eine KI bei Podcasts zuverlässig zwischen mehreren Sprechern wechseln?
Ja, moderne Tools kombinieren akustische Sprechererkennung (Diarisierung) mit visueller Gesichtserkennung. Dadurch kann das System identifizieren, wer gerade spricht, und automatisch zwischen Nahaufnahmen der sprechenden Person oder gestapelten Split-Screen-Ansichten wechseln, wenn ein aktiver Dialog stattfindet.
Warum ist ein manueller Review vor dem Posten von KI-Clips ratsam?
Automatisierte Systeme können Sarkasmus missverstehen, notwendigen Kontext vor dem Satzanfang weglassen oder Fachbegriffe phonetisch falsch transkribieren. Eine kurze redaktionelle Prüfung stellt sicher, dass der Hook sauber sitzt, das Bild stabil bleibt und die inhaltliche Aussage exakt gewahrt wird.
Bereit, Ihren Video-Workflow effizienter zu gestalten? Erfahren Sie, wie der KI-Clip-Generator Ihr Ausgangsmaterial analysiert, das vertikale Reframing übernimmt und lippensynchrone Untertitel erstellt – während Sie jederzeit die volle redaktionelle Kontrolle behalten.
Probiere es mit deiner eigenen Folge
10 Minuten Verarbeitung kostenlos, ohne Kreditkarte. Die Dauer hängt von der Videolänge und der Warteschlange ab; prüfe jeden Clip vor dem Veröffentlichen.