Cómo los creadores de clips con IA procesan, reencuadran y subtitulan videos de YouTube
Descubre cómo un creador de clips con IA para YouTube analiza transcripciones, reencuadra a formato vertical 9:16 y genera subtítulos palabra por palabra.
Actualizado el Por ClipFlap editorial team
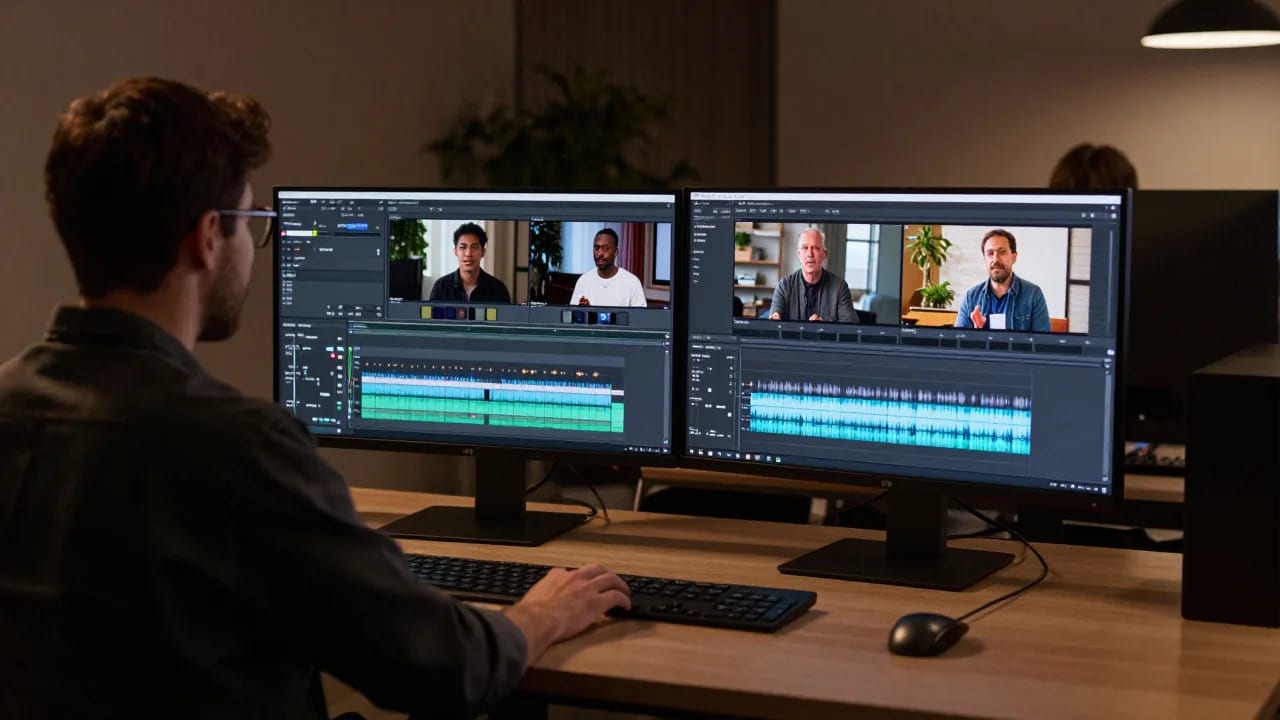
Reutilizar videos de formato largo para crear shorts verticales se ha convertido en una estrategia de distribución estándar, pero revisar manualmente líneas de tiempo de varias horas exige una enorme inversión de tiempo y concentración. Un creador de clips con IA para YouTube acelera este flujo de trabajo al transformar entrevistas grabadas, podcasts y ponencias en fragmentos breves y bien estructurados. En lugar de depender de la intuición, estos sistemas combinan transcripción automatizada, seguimiento visual y análisis acústico para identificar ideas completas e independientes.
Comprender la arquitectura técnica detrás de este proceso ayuda a editores de video, podcasters y equipos de contenido a evaluar qué pueden lograr las herramientas automatizadas y en qué puntos el criterio editorial humano sigue siendo indispensable.
El flujo de trabajo técnico: cómo la IA procesa y analiza videos largos de YouTube
Automatizar la transición de una emisión horizontal en YouTube a un clip vertical no se reduce a un solo cálculo. Exige una secuencia coordinada de modelos de aprendizaje automático especializados que procesan datos de audio y video en simultáneo.
Cuando se procesa un archivo de video o un enlace, el sistema separa el contenedor en flujos independientes de audio y video:
- Separación de audio (Demuxing): Se aísla y normaliza la pista de audio para eliminar picos de ruido de fondo y optimizar la claridad vocal.
- Transcripción de voz a texto: Un modelo de reconocimiento de voz convierte el diálogo hablado en un flujo de texto con marcas de tiempo, registrando cada palabra con precisión de milisegundos.
- Análisis de ondas de audio: Las curvas de volumen, las pausas, las variaciones de tono y los picos acústicos repentinos se indexan en paralelo con el texto.
- Decodificación mediante visión artificial: Se muestrea la pista de video para detectar cambios de escena, cortes de plano y puntos de referencia faciales.
Una vez sincronizadas estas capas de datos, una herramienta de recorte de video con IA puede empezar a analizar el contenido en busca de una estructura narrativa, en lugar de tratar el archivo como píxeles estáticos.
Análisis basado en transcripción: cómo detectan los algoritmos ganchos y arcos narrativos sólidos
Encontrar un clip aprovechable requiere algo más que detectar un diálogo entusiasta: exige identificar una unidad narrativa completa. Las conversaciones largas están repletas de sobreentendidos contextuales, digresiones e ideas interrumpidas que pierden fuerza cuando se aíslan en los feeds de redes sociales.
Detección de límites semánticos
Mediante el procesamiento del lenguaje natural (PLN), el sistema evalúa la transcripción para discernir dónde comienzan y terminan las ideas individuales. El algoritmo agrupa oraciones en bloques temáticos midiendo la similitud semántica entre frases adyacentes. Cuando el tema cambia de forma sustancial, se genera una marca de límite o frontera.
Identificación de ganchos iniciales y resoluciones
Para que la detección automática de momentos destacados funcione con precisión, el algoritmo califica los segmentos candidatos según su cohesión narrativa:
- El gancho inicial (hook): Los algoritmos buscan afirmaciones categóricas, preguntas provocadoras o introducciones temáticas claras cerca del inicio de cada bloque.
- Completitud sintáctica: Los fragmentos que dependen en exceso de pronombres no resueltos o referencias externas (como "como comentamos antes") reciben una puntuación más baja porque carecen de contexto autónomo.
- El clímax o remate: El sistema rastrea conclusiones narrativas, resúmenes clave o remates humorísticos, a menudo corroborados por análisis de audio que registran risas o inflexiones de voz enfáticas.
Mediante la extracción de clips basada en transcripciones, el software identifica fragmentos potenciales de entre 30 y 90 segundos que conservan una lógica interna propia sin exigir conocimientos previos al espectador.
Visión artificial y reencuadre: adaptación de tomas horizontales a formato vertical 9:16
La mayor parte del contenido de YouTube se graba en una relación de aspecto horizontal de 16:9. Convertir este metraje a un formato de video vertical exige un reencuadre inteligente en lugar de un recorte central estático, que con frecuencia deja fuera de plano a quien está hablando.
Detección facial y diarización de locutores
Para mantener el foco visual centrado, el software empareja el reconocimiento facial con la diarización de audio. La diarización distingue "quién habló y cuándo" mapeando las frecuencias vocales de cada participante. Cuando el interlocutor A toma la palabra, el modelo de visión artificial localiza el cuadro delimitador (bounding box) de sus coordenadas y centra la cámara virtual en su rostro.
Movimiento dinámico y suavizado de cámara
Si un sujeto se desplaza por el plató o gesticula, la visión artificial rastrea el cuadro delimitador a lo largo de los fotogramas sucesivos. En lugar de dar saltos bruscos —lo que provocaría tirones visuales robóticos y molestos—, el software aplica curvas matemáticas de suavizado para simular el paneo fluido propio de un operador de cámara experimentado.
Composiciones para múltiples interlocutores
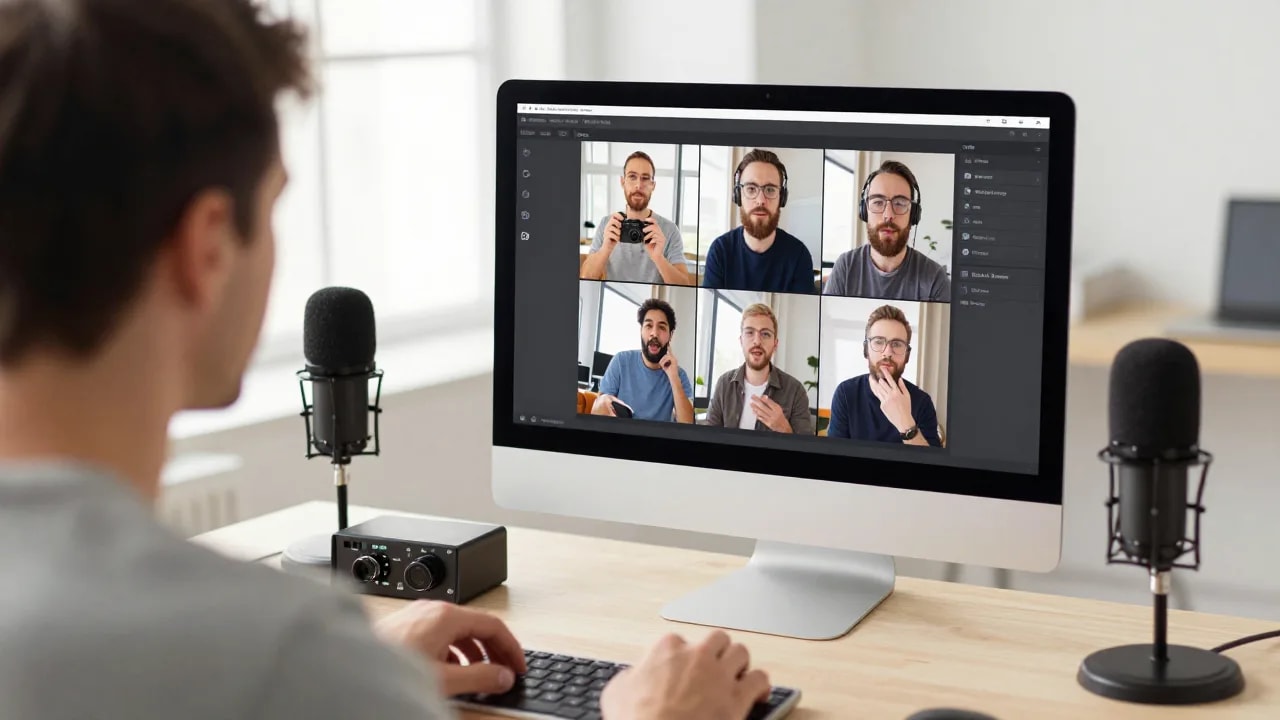
En podcasts con dos presentadores o mesas redondas, el encuadre dinámico se vuelve más complejo. Muchos creadores recurren a un flujo de trabajo para convertir podcasts en clips que alterna de forma dinámica entre diseños de pantalla dividida (mostrando a anfitrión e invitado simultáneamente) y planos individuales del orador activo, según el ritmo del diálogo y la superposición de voces.
Generación de subtítulos palabra por palabra: correspondencia fonética y tipografía visual
Los subtítulos resultan esenciales en los feeds verticales, donde una gran parte de los usuarios consume contenido sin auriculares. Los subtítulos tradicionales —que muestran dos líneas estáticas de texto en la parte inferior de la pantalla— suelen sustituirse en redes sociales por subtítulos cinéticos dinámicos.
Alineación forzada acústica
Generar subtítulos sincronizados palabra por palabra con IA se basa en la alineación forzada (forced alignment). El motor de voz a texto descompone las palabras transcritas en sus fonemas constituyentes (las unidades mínimas de sonido) y las alinea directamente con las marcas de milisegundos correspondientes en la onda de audio. Esto garantiza que el texto visual aparezca en perfecta sincronía con la voz del interlocutor.
Tipografía visual y ritmo de lectura
Una vez calculado el minutaje exacto, los motores de renderizado aplican estilos tipográficos:
- Mostrar bloques breves y fáciles de leer (de una a tres palabras por vez) para sostener la atención del espectador.
- Resaltar las palabras activas con colores de contraste o sutiles animaciones de escala.
- Respetar las zonas seguras verticales para evitar que los elementos de la interfaz de la plataforma (como nombres de usuario, botones de reacción o cajas de comentarios) tapen los subtítulos.
Limitaciones técnicas: dónde puede fallar la selección automática de momentos
Aunque la automatización asume una gran carga de trabajo computacional, los modelos de aprendizaje automático no poseen una comprensión real del contexto. Los creadores que confían plenamente en una automatización sin supervisión suelen toparse con puntos de fricción predecibles:
- Truncamiento contextual: El algoritmo puede seleccionar una frase llamativa pero cortar por error la aclaración previa indispensable que le daba sentido.
- Ironía y sarcasmo: Los modelos de procesamiento de lenguaje natural suelen tener dificultades con el humor seco o el sarcasmo, interpretando a veces afirmaciones satíricas como declaraciones literales.
- Solapamiento de voces y filtración de audio: Cuando dos invitados hablan al mismo tiempo con micrófonos no aislados, los modelos de seguimiento de hablantes pueden desorientarse, haciendo que el encuadre salte de forma errática de una persona a otra.
- Malinterpretación de pausas no verbales: Una pausa dramática pensada con fines cómicos o emocionales puede ser clasificada por los algoritmos de detección de silencios como tiempo muerto, provocando un corte antinatural en mitad de una idea.
Reconocer estas limitaciones técnicas explica con claridad por qué un borrador generado por algoritmos debe considerarse un punto de partida y no una pieza terminada.
Revisión con intervención humana: perfeccionar los borradores de IA antes de exportar y publicar
Transformar un borrador preliminar en un clip de alta retención requiere una revisión editorial manual. Al combinar la velocidad algorítmica con el criterio humano, los creadores pueden generar contenido impecable en una fracción del tiempo que exige la edición manual tradicional.
Lista de verificación de calidad antes de publicar
Antes de exportar clips de tu flujo de trabajo de videos de YouTube a shorts con IA, comprueba estos cuatro aspectos técnicos clave:
- Verificación del contexto: ¿Tiene el clip pleno sentido para alguien que jamás ha visto tu canal?
- Ajuste de límites: Amplía el inicio o el final del clip en 1 o 2 segundos si el algoritmo cortó una respiración natural o una frase introductoria.
- Integridad del encuadre visual: Comprueba que movimientos rápidos de manos o cambios posturales no hayan provocado saltos de reencuadre bruscos.
- Precisión de términos y jerga: Revisa nombres de marcas, tecnicismos o expresiones coloquiales que el reconocimiento automático de voz pudiera haber interpretado solo fonéticamente.
El uso de plataformas especializadas como ClipFlap permite a los creadores aprovechar la selección de momentos destacados basada en transcripciones, el reencuadre automático y los subtítulos sincronizados por palabra, manteniendo a la vez el control total de la línea de tiempo para ajustar límites, pulir la tipografía y calibrar la posición de los oradores antes de publicar.
Preguntas frecuentes
¿Cómo identifica un creador de clips con IA qué partes de un video de YouTube merece la pena recortar?
Las herramientas de IA evalúan los videos sincronizando las transcripciones de voz a texto con la energía del audio y la información visual. Los modelos de procesamiento de lenguaje natural identifican límites temáticos, ganchos narrativos y remates, mientras que los modelos acústicos detectan cambios de volumen, risas o ritmos enfáticos para localizar momentos conversacionales que funcionen de forma autónoma.
¿Por qué los subtítulos sincronizados palabra por palabra son más eficaces en clips cortos que los subtítulos estándar?
Los subtítulos sincronizados palabra por palabra muestran texto cinético y resaltado que coincide con el milisegundo exacto en que se pronuncia cada palabra. Este formato refuerza la cadencia de la conversación, mantiene la mirada del espectador centrada en el tercio medio vertical y se adapta al consumo sin sonido sin saturar la pantalla con bloques de texto de varias líneas.
¿Pueden los generadores de clips con IA seguir con precisión a varios interlocutores durante un podcast?
Sí, los generadores de clips modernos combinan diarización de audio con seguimiento facial óptico para detectar quién está hablando y reajustar el encuadre. Los sistemas más avanzados pueden alternar entre planos individuales del orador activo y formatos de pantalla dividida apilada cuando ambos participantes interactúan al mismo tiempo.
¿Por qué se recomienda una revisión manual antes de publicar clips de video generados con IA?
Los sistemas automatizados pueden malinterpretar el sarcasmo, cortar contexto conversacional imprescindible o transcribir erróneamente nombres de marca y terminología técnica. Una revisión editorial rápida asegura que el gancho empiece limpio, el encuadre se mantenga estable y el mensaje refleje fielmente la intención del creador.
¿Quieres agilizar tu flujo de trabajo de reutilización de video? Descubre cómo este generador de clips con IA analiza tu material original, automatiza el reencuadre vertical y crea subtítulos sincronizados, manteniendo siempre tu criterio editorial al mando.
Pruébalo con tu propio episodio
10 minutos de procesamiento gratis, sin tarjeta. El tiempo varía según la duración del vídeo y la cola; revisa cada clip antes de publicarlo.