Comment les générateurs de clips IA traitent, recadrent et sous-titrent les vidéos YouTube
Découvrez comment un générateur de clips IA pour YouTube analyse les transcriptions, recadre en 9:16 et synchronise les sous-titres au mot près.
Mis à jour le Par ClipFlap editorial team
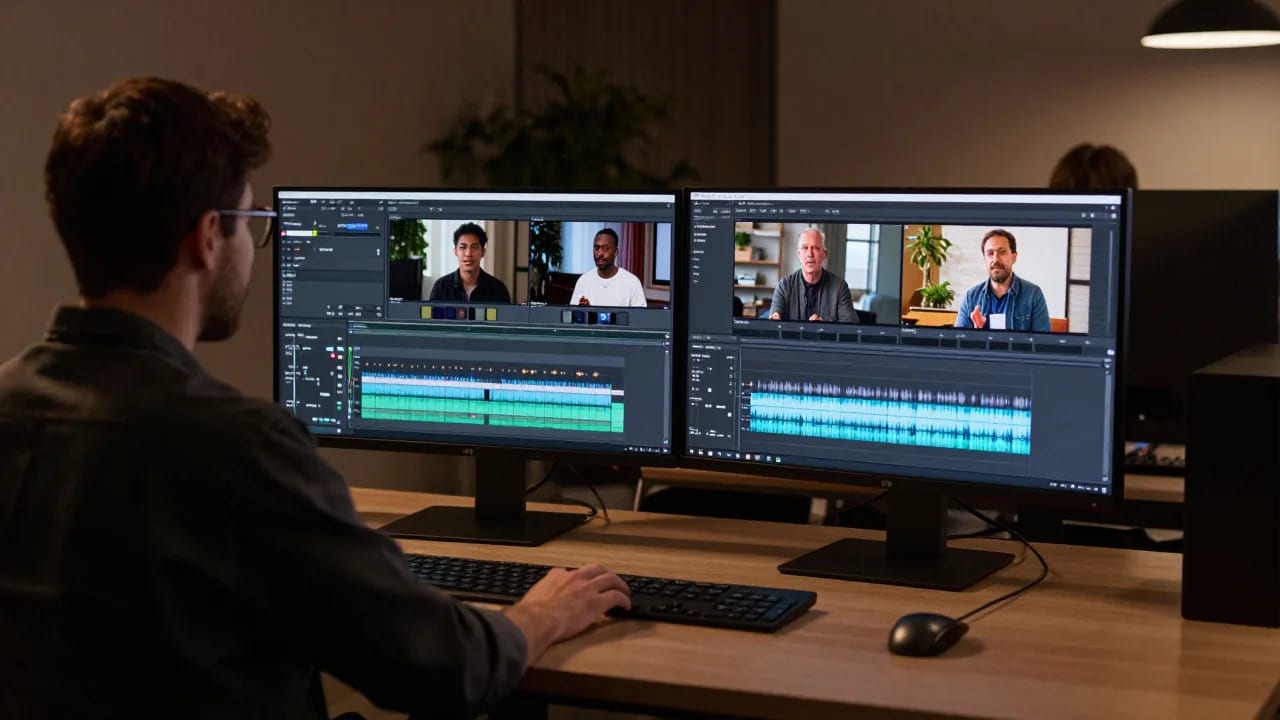
Recycler des vidéos longues en formats courts verticaux est devenu le socle de toute stratégie de diffusion moderne. Pourtant, parcourir manuellement des heures de rushs sur une timeline demande une énergie considérable. Un générateur de clips IA pour YouTube accélère radicalement ce flux de travail en transformant des interviews, des podcasts ou des conférences en extraits percutants et structurés. Loin d'opérer au hasard, ces systèmes combinent transcription automatique, suivi visuel et analyse acoustique pour isoler des arguments autonomes et captivants.
Comprendre les coulisses de ce pipeline permet aux monteurs, créateurs de podcasts et équipes de contenu d'évaluer avec précision ce que l'automatisation accomplit avec brio — et là où le regard éditorial humain demeure indispensable.
Le pipeline complet : comment l'IA ingère et analyse le contenu long format de YouTube
Transformer une vidéo YouTube horizontale en un clip vertical optimisé pour les réseaux sociaux ne se résume pas à un simple filtre algorithmique. Ce processus mobilise une chaîne de modèles d'apprentissage automatique interconnectés, capables d'analyser simultanément l'image et le son.
Dès qu'un fichier vidéo ou un lien est importé, le système décompose le conteneur multimédia en flux distincts :
- Démultiplexage audio : La piste sonore est isolée et normalisée afin de supprimer les bruits parasites et d'harmoniser le gain vocal.
- Reconnaissance vocale (Speech-to-Text) : Un modèle linguistique transcrit les dialogues en un flux textuel horodaté, consignant chaque mot à la milliseconde près.
- Analyse de la forme d'onde acoustique : L'intensité sonore, les silences, les intonations et les variations d'énergie sont cartographiés en regard du texte transcrit.
- Décodage par vision par ordinateur : Le flux vidéo est échantillonné afin d'identifier les transitions de scènes, les mouvements de caméra et les repères faciaux des intervenants.
Une fois ces données synchronisées, un outil de découpage vidéo IA peut disséquer la structure narrative du contenu plutôt que de traiter le média comme un simple assemblage de pixels statiques.
L'analyse basée sur la transcription : détection des accroches et des arcs narratifs
Créer un short percutant ne consiste pas seulement à repérer une hausse de volume ; il faut avant tout isoler une unité narrative complète. Les discussions longues regorgent de digressions, de sous-entendus ou d'idées interrompues qui perdent tout leur sens une fois isolées dans le fil d'actualité d'un réseau social.
Détection sémantique des transitions
Grâce au traitement automatique du langage naturel (NLP), le système examine la transcription pour comprendre précisément où commence et où se termine chaque réflexion. L'algorithme regroupe les phrases en blocs thématiques en mesurant la proximité sémantique des propositions successives. Dès qu'un changement de sujet s'opère, un point de découpe potentiel est posé.
Détection des accroches et des conclusions
Pour réussir la détection automatique des moments forts, l'algorithme attribue un score de cohérence narrative à chaque extrait candidat :
- L'accroche initiale (Hook) : Le modèle recherche des phrases affirmatives fortes, des questions provocatrices ou des annonces thématiques claires dès les premières secondes.
- L'autonomie syntaxique : Les segments qui débutent par des pronoms sans antécédent direct (comme « comme nous le disions tout à l'heure ») sont dévalorisés, car ils manquent de contexte pour un spectateur occasionnel.
- Le dénouement ou la chute : Le système repère les conclusions d'arguments, les synthèses percutantes ou les chutes humoristiques, souvent confirmées par une analyse acoustique indiquant des rires ou une intonation marquée.
Grâce à ce découpage vidéo basé sur la transcription, le logiciel isole des extraits de 30 à 90 secondes dotés d'une logique interne irréprochable, sans exiger de connaissances préalables de la part du spectateur.
Vision par ordinateur et recadrage : passer du format horizontal au format vertical 9:16
La majorité des vidéos YouTube sont tournées au format horizontal standard 16:9. Convertir ces contenus en vidéo verticale exige un recadrage intelligent plutôt qu'un rognage central fixe, qui laisserait fréquemment les intervenants hors champ.
Détection faciale et diarisation vocale
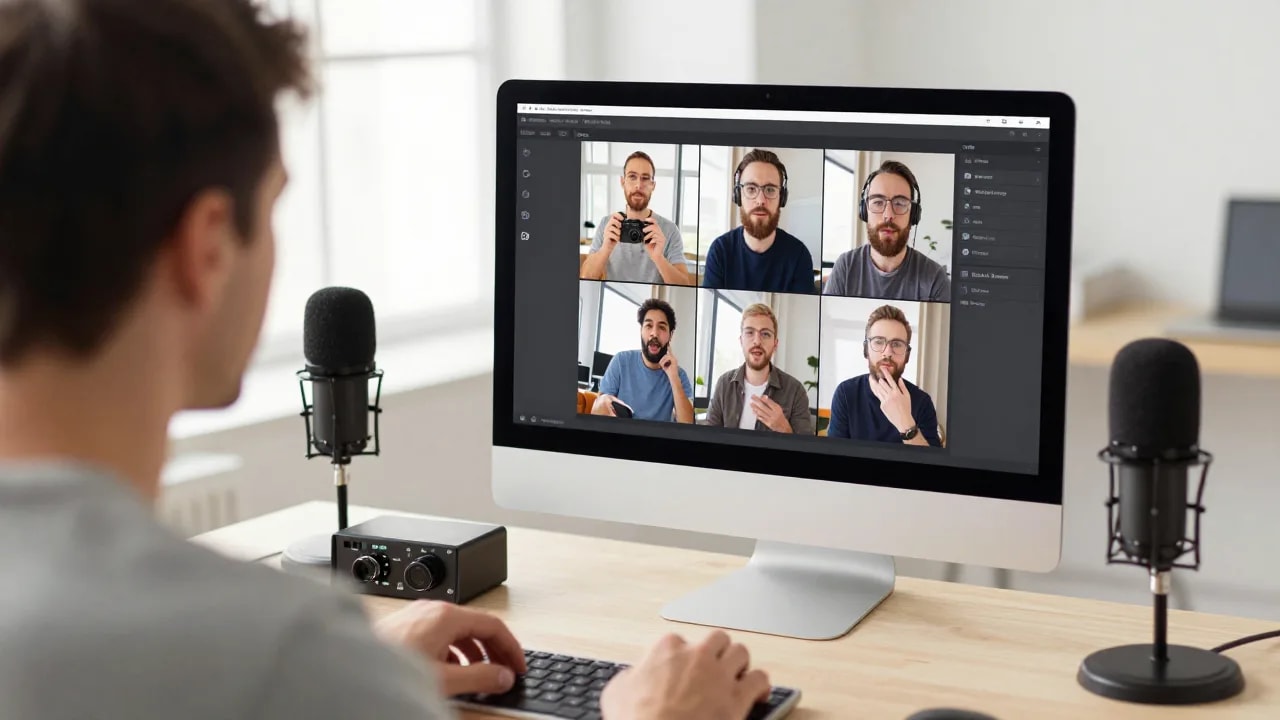
Pour maintenir le sujet au centre de l'attention, le logiciel croise la reconnaissance faciale avec la diarisation audio. Cette dernière identifie « qui parle et à quel moment » en analysant les caractéristiques fréquentielles propres à chaque voix. Dès que l'intervenant A prend la parole, la vision par ordinateur repère ses coordonnées spatiales et recentre la caméra virtuelle sur son visage.
Mouvements fluides et lissage de caméra
Si un sujet se déplace sur le plateau ou gesticule, l'algorithme suit sa boîte englobante image par image. Au lieu d'effectuer des sauts d'image saccadés et artificiels, le système applique des courbes d'interpolation mathématiques pour simuler les mouvements fluides et naturels d'un cadreur professionnel.
Gestion des scènes à plusieurs intervenants
Dans le cadre d'un débat ou d'un podcast à deux voix, le cadrage dynamique se complexifie. De nombreux créateurs privilégient alors un flux de type podcast vers clips. Ce mode alterne intelligemment entre des plans individuels sur l'orateur actif et des compositions en écran partagé (split-screen vertical) lorsque les deux protagonistes interagissent ou se coupent la parole.
Génération de sous-titres mot à mot : alignement phonétique et typographie dynamique
Les sous-titres sont indispensables sur les flux verticaux, où une grande partie de l'audience visionne les vidéos sans écouteurs. Les sous-titres traditionnels — deux lignes statiques empilées au bas de l'écran — sont aujourd'hui remplacés par des sous-titres cinétiques dynamiques.
Alignement forcé acoustique
L'intégration de sous-titres synchronisés au mot par mot par IA repose sur la méthode de l'alignement forcé. Le moteur de transcription décompose chaque terme en phonèmes (les briques élémentaires du langage articulé) et les fait coïncider exactement avec les millisecondes correspondantes du signal audio. Cette précision chirurgicale garantit que chaque mot s'affiche au moment exact où il est prononcé.
Typographie visuelle et maintien de l'attention
Une fois le calage temporel calculé, le moteur de rendu applique des règles graphiques adaptées à la rétention visuelle :
- Affichage par groupes courts (un à trois mots à la fois) pour soutenir le rythme de lecture.
- Mise en valeur du mot actif grâce à des couleurs contrastées ou de subtils zooms typographiques.
- Respect des zones de sécurité des plateformes afin que le texte ne soit jamais masqué par les boutons d'interaction, les noms d'utilisateurs ou les descriptions.
Limites techniques : là où la sélection automatisée peut échouer
Si l'intelligence artificielle exécute un travail préparatoire colossal, elle ne dispose d'aucune réelle conscience sémantique. Les créateurs qui s'en remettent à une automatisation totale sans surveillance se heurtent souvent à des écueils récurrents :
- Coupure contextuelle prématurée : L'algorithme peut retenir une affirmation choc tout en amputant la nuance indispensable prononcée juste avant.
- Ironie et second degré : Les modèles linguistiques peinent encore à interpréter le sarcasme ou le ton pince-sans-rire, prenant parfois des boutades au premier degré.
- Paroles simultanées et interférences : Si deux personnes parlent en même temps sur des pistes audio mal isolées, le suivi d'orateur peut hésiter et faire basculer le cadrage de manière erratique.
- Interprétation erronée des silences : Une pause dramatique voulue pour susciter l'émotion ou ménager un effet comique peut être interprétée comme un blanc inutile, provoquant une coupe maladroite au milieu d'une idée.
Ces contraintes techniques rappellent que la proposition de l'algorithme doit être considérée comme un premier montage fonctionnel et non comme un produit final indiscutable.
Révision humaine (« Human-in-the-Loop ») : affiner les brouillons de l'IA avant l'exportation
Pour transformer un extrait brut en un contenu à fort taux de rétention, l'intervention humaine reste déterminante. En combinant la vitesse de calcul des algorithmes avec le discernement d'un éditeur, vous produisez des vidéos soignées en une fraction du temps habituel.
Checklist qualité avant publication
Avant d'exporter votre projet issu d'une solution pour convertir une vidéo YouTube en Shorts avec l'IA, passez en revue ces quatre points de contrôle :
- Pertinence du contexte : L'extrait est-il parfaitement compréhensible pour quelqu'un qui découvre votre contenu pour la première fois ?
- Ajustement des coupes : Prolongez l'amorce ou la fin de l'extrait de 1 à 2 secondes si le moteur a tronqué une respiration ou un mot de liaison naturel.
- Stabilité du cadrage : Vérifiez qu'un mouvement brusque des bras ou un changement de posture n'a pas provoqué de recadrage saccadé.
- Orthographe et lexique spécialisé : Contrôlez les noms propres, acronymes techniques et termes familiers que la reconnaissance vocale automatique a pu transcrire de manière approximative.
Des plateformes spécialisées comme ClipFlap permettent de tirer parti de la détection de temps forts, du recadrage automatisé et du sous-titrage synchronisé, tout en vous laissant la liberté d'ajuster les curseurs temporels, d'éditer la typographie et de corriger le centrage des caméras avant la publication.
Foire aux questions
Comment un générateur de clips IA identifie-t-il les passages d'une vidéo YouTube qui méritent d'être extraits ?
Les outils d'IA croisent la transcription textuelle avec l'énergie audio et les variations visuelles. Les modèles de traitement du langage naturel isolent les transitions thématiques, les accroches et les conclusions, tandis que l'analyse sonore détecte les variations de volume, les éclats de rire ou les accélérations de débit afin d'extraire des segments de discussion complets et percutants.
Pourquoi les sous-titres synchronisés mot à mot sont-ils plus efficaces que les sous-titres traditionnels pour les formats courts ?
Les sous-titres animés mot à mot soulignent le rythme oral à la milliseconde près. Ils captent immédiatement le regard au centre de l'image verticale et améliorent la rétention, tout en rendant le contenu parfaitement accessible aux nombreux spectateurs qui consomment leurs flux sans activer le son.
Les générateurs de clips IA peuvent-ils suivre plusieurs intervenants avec précision lors d'un podcast ?
Oui, les générateurs modernes utilisent la diarisation audio couplée à la détection faciale pour identifier l'orateur actif et orienter la caméra virtuelle vers lui. Dans les moments d'échange rapide, les systèmes les plus avancés créent automatiquement un agencement vertical scindé (split-screen) pour afficher les deux intervenants en même temps.
Pourquoi est-il recommandé d'effectuer une relecture manuelle avant de publier des clips générés par l'IA ?
L'intelligence artificielle peut mal interpréter l'ironie, tronquer une précision contextuelle essentielle ou commettre des fautes d'orthographe sur des marques ou du vocabulaire technique. Une révision humaine rapide permet de vérifier la fluidité des coupes, la justesse des propos et la stabilité du cadrage avant la mise en ligne.
Prêt à transformer vos vidéos longues en contenus dynamiques ? Découvrez comment notre générateur de clips IA analyse vos enregistrements, ajuste le cadrage vertical et applique des sous-titres synchronisés, tout en vous préservant une maîtrise éditoriale absolue.
Essayez sur votre propre épisode
10 minutes de traitement offertes, sans carte bancaire. Le délai dépend de la durée de la source et de la charge de la file d’attente ; relisez chaque clip avant publication.