Cara AI Clip Maker untuk YouTube Memproses, Reframe, dan Buat Kapsyen
Pelajari cara AI clip maker untuk YouTube menganalisis transkrip, melacak pembicara, reframe ke rasio vertikal 9:16, dan menyusun teks otomatis per kata.
Diperbarui Oleh ClipFlap editorial team
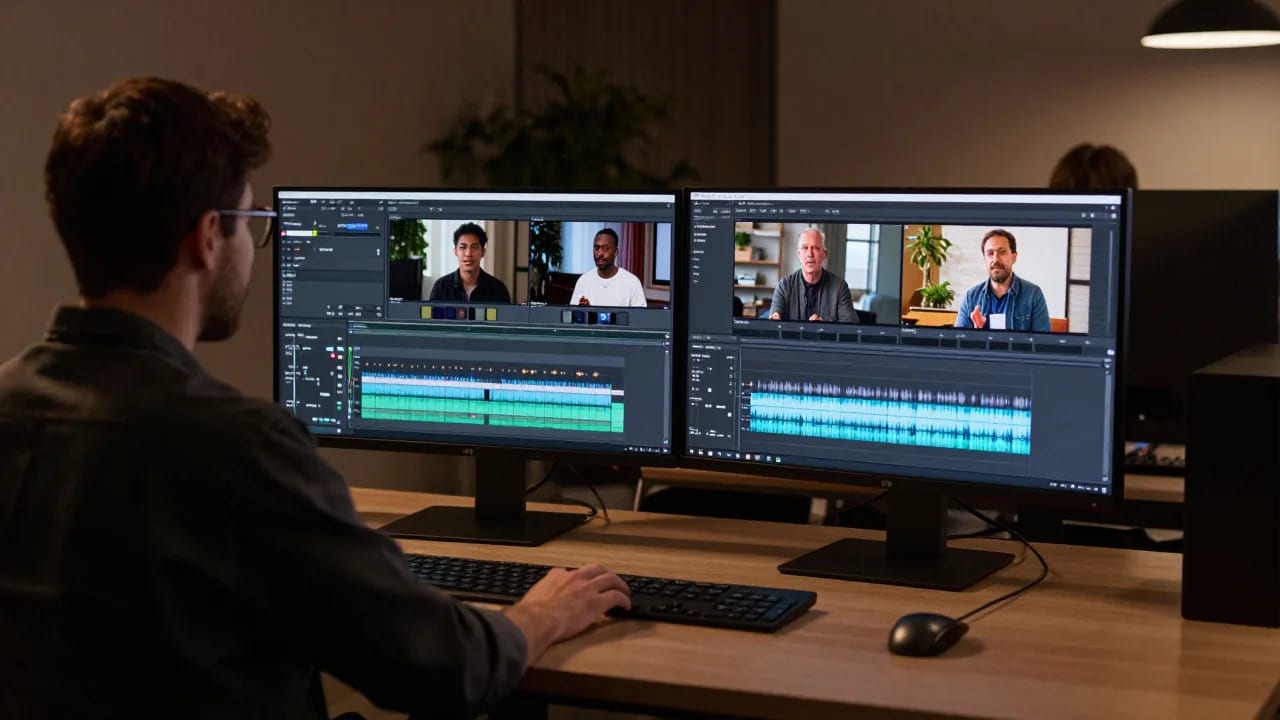
Mengubah video panjang menjadi format vertikal untuk Shorts, Reels, atau TikTok kini telah menjadi strategi distribusi standar. Kendati demikian, menyisir linimasa rekaman berjam-jam secara manual menyita banyak waktu dan energi. Sebuah AI clip maker untuk YouTube mempercepat alur kerja ini dengan mengonversi rekaman wawancara, podcast, serta presentasi menjadi segmen video pendek yang padat dan terstruktur. Alih-alih menebak secara acak, sistem cerdas ini memadukan transkripsi otomatis, pelacakan visual, dan analisis akustik guna mengidentifikasi poin pembicaraan yang utuh.
Memahami alur kerja teknis di baliknya membantu para editor video, podcaster, dan tim produksi mengevaluasi sejauh mana alat otomatis ini dapat diandalkan—serta di titik mana kurasi editorial manusia tetap memegang peranan mutlak.
Alur Kerja Bertahap: Cara AI Menerima dan Membedah Konten Panjang YouTube
Mengotomatiskan transisi dari video horizontal YouTube ke klip vertikal bukanlah kalkulasi satu langkah sederhana. Proses ini memerlukan serangkaian model machine learning khusus yang bekerja secara harmonis mengolah data audio dan visual.
Begitu berkas video atau tautan dimasukkan ke sistem, wadah media dipisahkan menjadi aliran data audio dan video yang terpisah:
- Audio Demuxing: Jalur audio diisolasi dan dinormalisasi untuk meredam lonjakan kebisingan latar belakang serta meningkatkan kejernihan vokal.
- Transkripsi Speech-to-Text: Model pengenalan suara (speech recognition) mengonversi dialog lisan menjadi teks dengan penanda waktu (timestamp) presisi hingga hitungan milidetik.
- Analisis Waveform Audio: Dinamika volume (envelopes), jeda hening, variasi nada suara, dan lonjakan akustik dipetakan sejajar dengan teks.
- Dekoding Computer Vision: Trek video dievaluasi untuk mendeteksi batas pergantian adegan, perpindahan sudut kamera, serta titik acuan wajah (facial landmarks).
Setelah lapisan data ini tersinkronisasi, sebuah alat pemotong video AI dapat mulai membedah konten berdasarkan struktur narasi logis, alih-alih sekadar memprosesnya sebagai kumpulan piksel statis.
Analisis Berbasis Transkrip: Cara Algoritma Menemukan Hook dan Alur Cerita yang Utuh
Menemukan klip pendek yang memikat membutuhkan lebih dari sekadar mendeteksi percakapan yang ekspresif; sistem harus menemukan unit narasi yang berdiri sendiri. Percakapan panjang sarat dengan konteks pendukung, topik sampingan, serta kalimat menggantung yang akan terasa membingungkan jika dipotong mentah-mentah ke lini masa media sosial.
Deteksi Batas Semantik
Memanfaatkan pemrosesan bahasa alami (natural language processing atau NLP), sistem mengevaluasi transkrip untuk memetakan titik awal dan akhir sebuah gagasan. Algoritma mengelompokkan kalimat ke dalam kluster tematik dengan mengukur kemiripan semantik antarfrasa yang berdekatan. Ketika terjadi pergeseran topik yang signifikan, penanda batas (boundary marker) akan ditetapkan secara otomatis.
Menemukan Hook dan Konklusi Cerita
Agar deteksi highlight video otomatis membuahkan hasil yang tajam, algoritma memberi skor pada kandidat segmen berdasarkan kohesi narasinya:
- Hook Pembuka: Algoritma memindai pernyataan lugas, pertanyaan provokatif, atau pengantar tematik yang kuat di awal batas segmen.
- Kelengkapan Sintaksis: Segmen yang terlalu bergantung pada kata ganti tanpa acuan yang jelas (misalnya "seperti yang kita bicarakan tadi") mendapat skor kelayakan mandiri yang lebih rendah karena membingungkan penonton baru.
- Klimaks atau Punchline: Sistem mencari konklusi naratif, ringkasan inti, atau lelucon penutup (punchline), yang sering kali diperkuat oleh analisis waveform audio berupa tawa audiens atau intonasi suara yang tegas.
Melalui pemotongan video berbasis transkrip, perangkat lunak menyaring potensi segmen berdurasi 30 hingga 90 detik yang memiliki kelogisan internal utuh tanpa menuntut penonton memahami konteks keseluruhan video aslinya.
Computer Vision dan Reframing: Mengubah Format Horizontal ke Vertikal 9:16
Sebagian besar materi YouTube direkam dalam rasio aspek lanskap 16:9. Mengubah rekaman ini menjadi video vertikal menuntut pembingkaian ulang (intelligent reframing), bukan sekadar memotong bagian tengah secara statis (center-crop) yang kerap membuat subjek aktif terpotong dari pandangan.
Deteksi Wajah dan Diarisasi Pembicara
Agar fokus visual tetap berada di tengah layar, perangkat lunak menyandingkan pengenalan wajah (facial recognition) dengan diarisasi audio (speaker diarization). Diarisasi audio membedakan "siapa yang berbicara dan kapan" dengan memetakan spektrum frekuensi vokal. Ketika Pembicara A berbicara, model computer vision mencari koordinat kotak pembatas (bounding box) Pembicara A lalu memusatkan kamera virtual pada wajahnya.
Gerakan Dinamis dan Pelembutan Kamera
Ketika pembicara bergerak atau membuat gestur dinamis, computer vision melacak pergerakan koordinat tersebut dari bingkai ke bingkai. Alih-alih melompat secara kaku—yang menimbulkan sentakan visual artifisial—perangkat lunak menerapkan kurva pelembutan matematis demi menciptakan efek geser (panning) mulus layaknya juru kamera profesional.
Tata Letak Multi-Pembicara
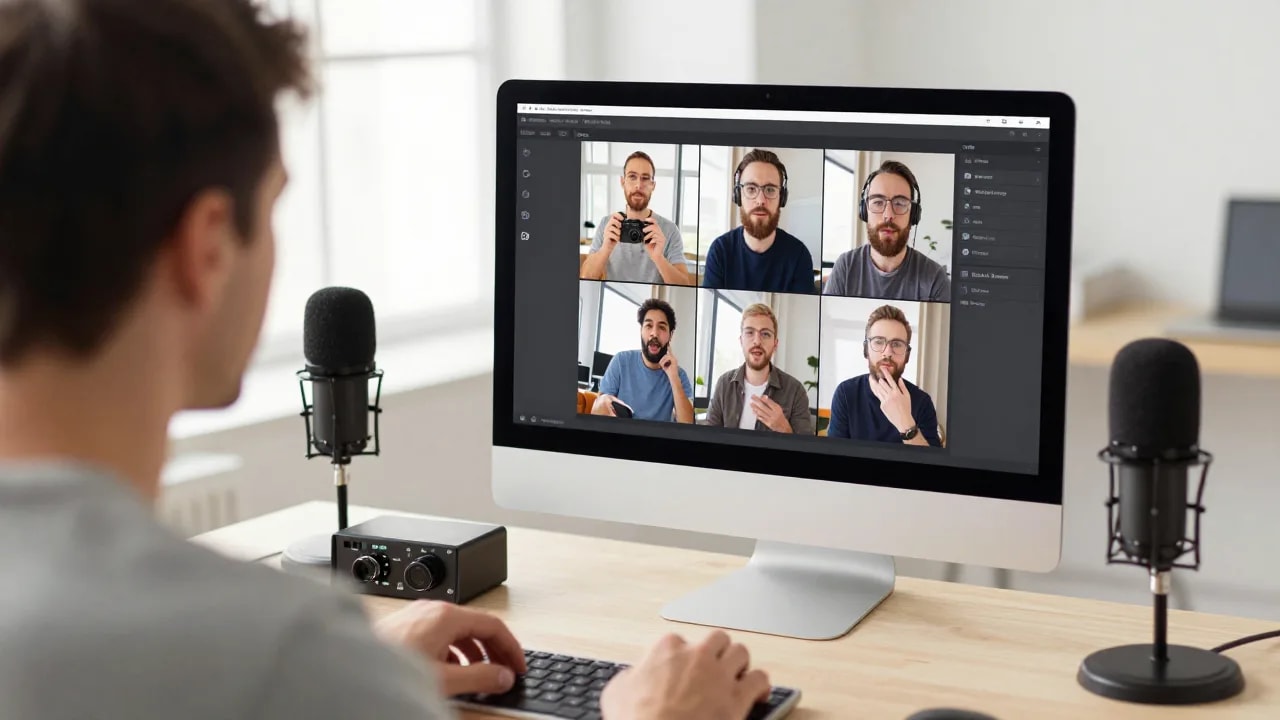
Pada siniar dua orang atau diskusi panel, pembingkaian dinamis menjadi lebih kompleks. Banyak kreator menerapkan alur kerja podcast to clips yang secara adaptif berpindah antara tampilan layar terbagi (split-screen, menampilkan pembawa acara dan narasumber sekaligus) dan bidikan fokus ke pembicara aktif, menyesuaikan dengan tempo obrolan serta momen saling menimpali dialog.
Pembuatan Teks Otomatis per Kata: Pencocokan Fonem dan Tipografi Visual
Keberadaan teks takarir sangat krusial bagi format vertikal, mengingat sebagian besar audiens menonton konten tanpa mengaktifkan pelantang suara. Subtitel konvensional—yang menaruh dua baris teks statis di bagian bawah—kini mulai ditinggalkan di media sosial dan digantikan oleh takarir kinetik yang dinamis.
Acoustic Forced Alignment
Pembuatan teks otomatis per kata (word-timed captions) berbasis AI memanfaatkan teknik forced alignment. Mesin speech-to-text memecah kata hasil transkripsi menjadi fonem (satuan bunyi terkecil) lalu menyelaraskannya langsung dengan penanda milidetik yang cocok pada gelombang suara audio. Proses ini memastikan teks visual terpampang serempak persis mengikuti lafal pembicara.
Tipografi Visual dan Ritme Tampilan
Setelah sinkronisasi waktu terhitung sempurna, mesin render mengaplikasikan gaya tipografi:
- Menampilkan susunan kata ringkas (satu hingga tiga kata sekaligus) untuk mengunci atensi penonton.
- Menyorot kata yang sedang diucapkan menggunakan warna kontras atau animasi pembesaran skala yang halus.
- Mempertahankan batas area aman (vertical safe zones) agar takarir tidak terhalang oleh elemen antarmuka aplikasi, seperti nama akun, tombol apresiasi, dan kolom komentar.
Keterbatasan Teknis: Titik Rawan Seleksi Momen Otomatis
Kendati otomatisasi memangkas beban komputasi yang berat, model machine learning tidak memiliki daya pemahaman konteks layaknya manusia. Kreator yang sepenuhnya bergantung pada otomatisasi tanpa pengawasan sering menemui kendala umum berikut:
- Konteks Terpotong: Algoritma bisa saja memilih pernyataan yang menggelegar, namun secara tidak sengaja memangkas kalimat sanggahan penting tepat sebelum pernyataan tersebut disampaikan.
- Ironi dan Sarkasme: Model pemrosesan bahasa alami masih sulit menangkap humor sarkastis atau lelucon bernada datar (deadpan), terkadang menganggap ujaran satir sebagai fakta harfiah.
- Bicara Bersamaan dan Audio Bocor (Cross-Talk): Ketika dua narasumber berbicara serentak pada mikrofon yang tidak terisolasi dengan baik, pelacak pembicara dapat mengalami disorientasi dan memicu perpindahan sorotan kamera yang berantakan.
- Salah Tafsir Isyarat Non-Verbal: Jeda hening yang sengaja dibangun demi dramatisasi atau efek komedi dapat dikira sebagai kekosongan suara (dead air) oleh sistem, berujung pada pemotongan kalimat yang canggung.
Menyadari batasan teknis ini menegaskan mengapa draf seleksi AI sebaiknya difungsikan sebagai fondasi awal, bukan produk akhir yang langsung diterbitkan.
Kurasi Human-in-the-Loop: Menyempurnakan Draf AI Sebelum Ekspor dan Publikasi
Mengolah draf awal menjadi klip video pendek dengan retensi tinggi tetap menuntut sentuhan editorial manusia. Dengan mengawinkan kecepatan algoritma dan kepekaan intuisi kreator, hasil akhir yang profesional dapat tercapai dalam separuh waktu penyuntingan manual.
Checklist Kualitas Sebelum Publikasi
Sebelum mengekspor klip dari alur kerja YouTube ke Shorts AI Anda, tinjau empat parameter teknis berikut:
- Verifikasi Konteks: Apakah klip tersebut dapat dipahami dengan utuh oleh penonton yang belum pernah melihat kanal Anda sama sekali?
- Penyesuaian Batas Segmen: Tambahkan durasi 1–2 detik di awal atau akhir segmen jika algoritma memotong tarikan napas atau frasa pengantar.
- Integritas Pembingkaian Visual: Pastikan gestur tangan yang mendadak atau pergeseran posisi duduk tidak memicu reframing yang berguncang.
- Akurasi Transkrip dan Istilah Khusus: Periksa istilah teknis, nama merek, dan istilah gaul yang berisiko salah ditranskripsikan secara fonetik oleh mesin pengenal suara.
Memanfaatkan platform terdedikasi seperti ClipFlap memberi kreator keunggulan seleksi sorotan berbasis transkrip, reframing otomatis, dan teks dinamis per kata, sembari tetap memegang kendali penuh pada linimasa untuk menyesuaikan batas durasi, merapikan tipografi, dan menyempurnakan posisi pembicara sebelum diunggah.
Pertanyaan yang Sering Diajukan (FAQ)
Bagaimana cara AI clip maker menentukan bagian video YouTube yang layak dipotong?
Alat AI mengevaluasi video dengan mengintegrasikan transkrip speech-to-text bersama dinamika gelombang audio dan visual. Model pemrosesan bahasa alami mendeteksi batasan topik, kalimat pembuka pemikat (hook), serta konklusi cerita, sementara model akustik memeriksa lonjakan volume, tawa, atau intonasi penekanan guna menemukan momen percakapan yang berdiri sendiri.
Mengapa teks otomatis per kata lebih efektif untuk video pendek dibanding subtitel standar?
Teks otomatis per kata (word-timed captions) menampilkan teks kinetik tersorot yang selaras hingga skala milidetik saat kata diucapkan. Format ini mempertegas ritme percakapan, mengarahkan fokus mata penonton ke area tengah layar vertikal, serta ramah bagi pengguna yang menonton dalam kondisi suara senyap tanpa menumpuk baris teks berlebih di layar.
Bisakah generator klip AI melacak banyak pembicara secara akurat dalam sebuah podcast?
Bisa. Generator klip modern menyinergikan diarisasi audio dengan pelacakan wajah visual untuk mendeteksi siapa yang sedang bersuara dan mengatur pembingkaian kamera secara adaptif. Sistem tingkat lanjut bahkan mampu beralih mulus antara bidikan tunggal pembicara aktif dan tata letak layar terbagi (split-screen) saat peserta saling berinteraksi secara aktif.
Mengapa evaluasi manual tetap disarankan sebelum mengunggah klip video buatan AI?
Sistem otomatis dapat salah menangkap konteks sarkasme, memangkas penjelasan penting di awal kalimat, atau keliru mengeja istilah teknis dan nama merek. Peninjauan editorial singkat memastikan hook pembuka tersaji rapi, pembingkaian kamera stabil, dan makna pesan tetap sesuai dengan intensi awal kreator.
Siap menyederhanakan alur kerja repurposi video Anda? Pelajari bagaimana generator klip AI menganalisis materi rekaman, mengotomatiskan reframing vertikal, dan menyusun teks tersinkronisasi dengan tetap memberikan Anda kendali editorial sepenuhnya.
Coba dengan episode kamu sendiri
10 menit pemrosesan gratis, tanpa kartu kredit. Durasinya tergantung panjang video dan antrean; periksa setiap klip sebelum mengunggah.