Come gli AI Clip Maker Elaborano, Riadattano e Sottotitolano i Video di YouTube
Scopri come un AI clip maker per YouTube analizza trascrizioni, traccia speaker, converte in 9:16 e genera sottotitoli sincronizzati parola per parola.
Aggiornato il Di ClipFlap editorial team
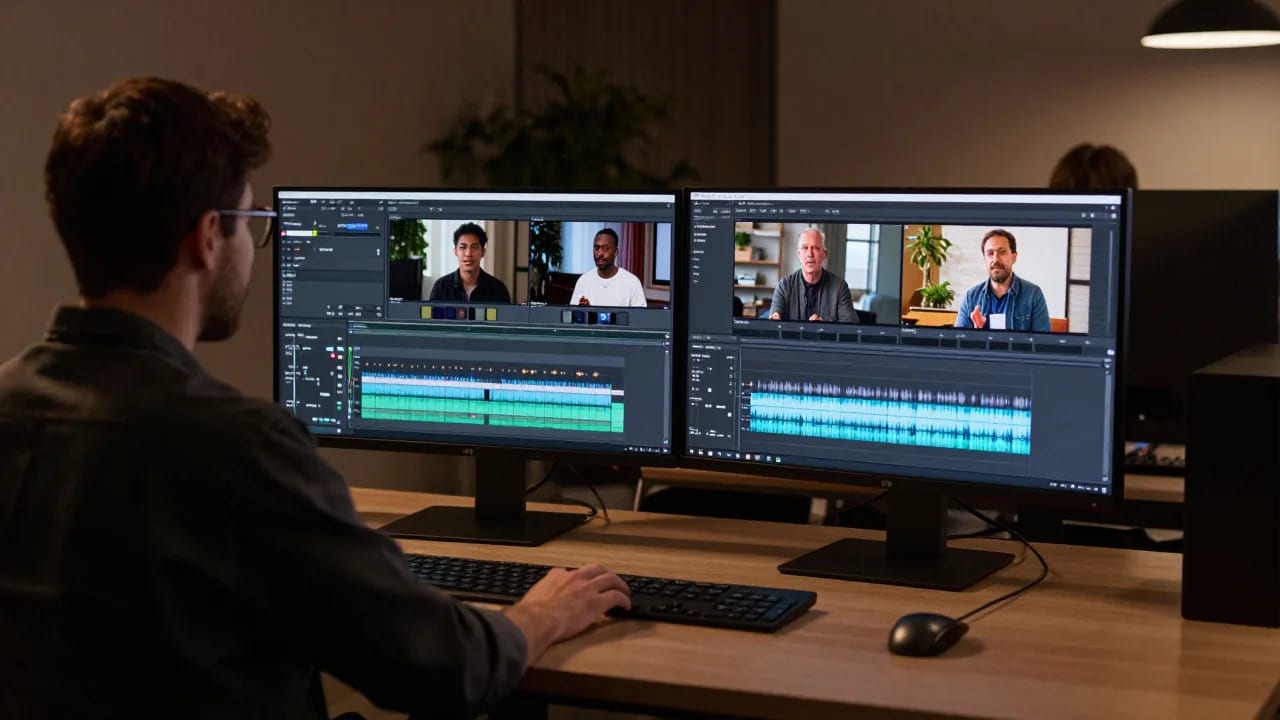
Il riutilizzo di contenuti video lunghi (repurposing) per creare Short verticali è ormai una strategia di distribuzione fondamentale, ma scorrere manualmente timeline di svariate ore richiede una quantità enorme di tempo e concentrazione. Un AI clip maker per YouTube accelera questo flusso di lavoro trasformando interviste registrate, podcast e presentazioni in segmenti brevi e strutturati. Anziché affidarsi a tentativi casuali, questi sistemi combinano trascrizione automatizzata, tracciamento visivo e analisi acustica per individuare passaggi concettualmente autonomi.
Comprendere la pipeline tecnica alla base di questi strumenti aiuta video editor, podcaster e team di contenuti a valutare cosa l'automazione possa effettivamente realizzare e dove il giudizio editoriale umano rimanga insostituibile.
La pipeline in più fasi: come l'AI acquisisce e analizza i contenuti lunghi di YouTube
Automatizzare il passaggio da una trasmissione orizzontale su YouTube a una clip verticale non si riduce a un singolo calcolo matematico. Richiede una sequenza di modelli di machine learning specializzati che operano all'unisono su dati audio e video.
Quando viene caricato un file video o inserito un link, il sistema separa il container multimediale in flussi audio e video distinti:
- Demuxing audio: la traccia audio viene isolata e normalizzata per eliminare picchi di rumore di fondo e ottimizzare la nitidezza.
- Trascrizione speech-to-text: un modello di riconoscimento vocale converte il dialogo parlato in un flusso di testo con timestamp, registrando ogni parola al millisecondo.
- Analisi della forma d'onda audio: inviluppi di volume, pause, variazioni di intonazione e picchi sonori improvvisi vengono indicizzati insieme al testo.
- Decodifica tramite computer vision: la traccia video viene campionata per rilevare cambi di scena, stacchi di camera e punti di riferimento facciali (facial landmark).
Una volta sincronizzati questi livelli di dati, uno strumento di clipping video AI può iniziare ad analizzare il contenuto in base alla sua struttura narrativa, anziché trattare il filmato come una semplice sequenza di pixel statici.
Analisi basata sulla trascrizione: come gli algoritmi individuano hook e archi narrativi coerenti
Individuare una clip breve efficace richiede molto più che notare un momento di dialogo particolarmente concitato: serve identificare un'unità narrativa autosufficiente. Le conversazioni lunghe sono piene di premesse contestuali, digressioni e pensieri lasciati a metà che perdono completamente di efficacia se decontestualizzati nei feed social.
Rilevamento dei confini semantici
Attraverso l'elaborazione del linguaggio naturale (NLP), il sistema analizza la trascrizione per capire dove iniziano e dove finiscono i singoli concetti. L'algoritmo raggruppa le frasi in cluster tematici misurando la somiglianza semantica tra enunciati adiacenti. Quando l'argomento cambia in modo evidente, viene registrato un marcatore di confine.
Individuazione di hook e conclusioni
Affinché l'individuazione automatica degli highlight video abbia successo, l'algoritmo assegna un punteggio ai segmenti candidati in base alla loro coesione narrativa:
- L'hook iniziale: gli algoritmi cercano affermazioni forti, domande provocatorie o chiare introduzioni tematiche in prossimità dell'inizio di un segmento.
- Completezza sintattica: i segmenti che dipendono fortemente da riferimenti o pronomi non risolti (come "come dicevamo prima") ricevono punteggi inferiori per la fruizione autonoma, poiché privi del contesto circostante.
- Il climax o la battuta finale: il sistema rileva conclusioni narrative, sintesi efficaci o battute di spirito, spesso confermate dall'analisi della forma d'onda audio che segnala risate o un'intonazione più enfatica.
Grazie al clipping video basato sulla trascrizione, il software seleziona potenziali spezzoni tra i 30 e i 90 secondi che conservano una logica interna impeccabile senza richiedere conoscenze pregresse da parte dello spettatore.
Computer vision e reframing: convertire riprese orizzontali nel formato verticale 9:16
La maggior parte dei contenuti di YouTube viene registrata in formato orizzontale 16:9. Convertire queste riprese in un formato video verticale richiede un riadattamento intelligente dell'inquadratura (reframing), anziché un semplice ritaglio centrale fisso che spesso taglia fuori i soggetti che stanno parlando.
Riconoscimento facciale e diarizzazione degli speaker
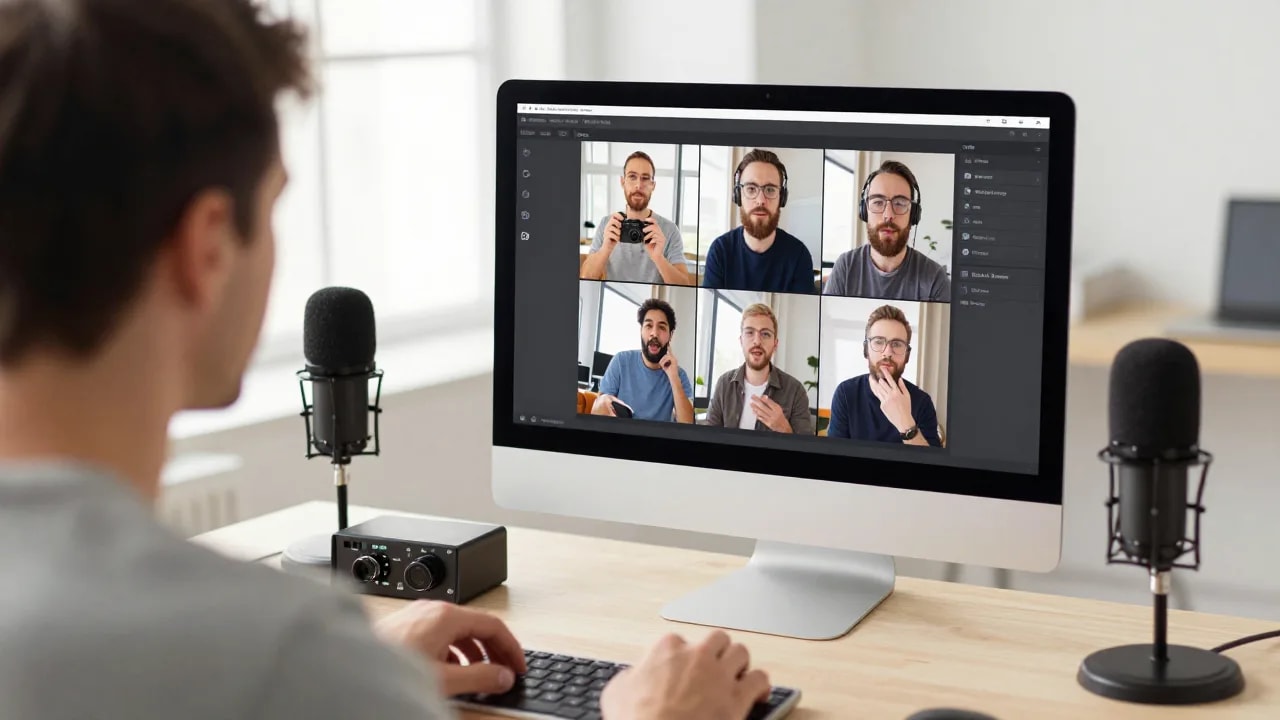
Per mantenere l'attenzione visiva centrata, il software abbina il riconoscimento facciale alla diarizzazione audio. La diarizzazione distingue "chi ha parlato e quando" mappando frequenze vocali differenti. Quando parla l'interlocutore A, il modello di computer vision individua il riquadro di delimitazione (bounding box) corrispondente e centra la telecamera virtuale sul suo volto.
Movimento dinamico e stabilizzazione dell'inquadratura
Se un soggetto si sposta sul set o gesticola, la computer vision traccia il riquadro nei fotogrammi successivi. Anziché scattare istantaneamente — provocando movimenti a scatti innaturali e robotici — il software applica curve matematiche di smoothing per simulare la panoramica fluida tipica di un operatore di camera esperto.
Layout per più interlocutori
Nei podcast a due voci o nelle tavole rotonde, l'inquadratura dinamica diventa più complessa. Molti creator utilizzano un flusso di lavoro da podcast a clip che alterna dinamicamente layout split-screen (mostrando host e ospite contemporaneamente) e cambi di inquadratura su chi parla, a seconda del ritmo della conversazione e delle sovrapposizioni vocali.
Generazione di sottotitoli a tempo di parola: abbinamento fonetico e tipografia dinamica
I sottotitoli sono fondamentali per i feed verticali, dove una percentuale considerevole di utenti guarda i video senza audio o cuffie. I sottotitoli tradizionali — che mostrano due righe statiche di testo nella parte inferiore dello schermo — sui social vengono spesso rimpiazzati da sottotitoli dinamici e cinetici.
Allineamento forzato acustico (Forced Alignment)
Generare sottotitoli AI sincronizzati parola per parola richiede l'allineamento forzato (forced alignment). Il motore speech-to-text scompone le parole trascritte nei loro fonemi costitutivi (le unità sonore minime) e le sincronizza direttamente con i marcatori al millisecondo nella forma d'onda audio. In questo modo il testo visivo compare in perfetto sincrono con la voce dello speaker.
Tipografia visiva e ritmo di lettura
Una volta calcolata la sincronizzazione temporale, i motori di rendering applicano lo stile tipografico:
- Mostrare gruppi di parole brevi e facili da leggere (da una a tre parole alla volta) per mantenere alta l'attenzione dello spettatore.
- Evidenziare la parola pronunciata in quel preciso istante con colori a contrasto o animazioni di ingrandimento appena accennate.
- Rispettare le zone di sicurezza verticali (safe zone) per evitare che i sottotitoli vengano coperti dagli elementi dell'interfaccia della piattaforma, come username, pulsanti di reazione e sezione commenti.
Limiti tecnici: dove la selezione automatizzata dei momenti può fallire
Sebbene l'automazione svolga la maggior parte del lavoro computazionale più pesante, i modelli di machine learning non possiedono una comprensione semantica cosciente. I creator che si affidano ciecamente a processi del tutto automatici si scontrano regolarmente con alcune criticità prevedibili:
- Troncamento del contesto: un algoritmo potrebbe isolare un'affermazione di grande impatto, tralasciando però una premessa fondamentale pronunciata pochi secondi prima.
- Ironia e sarcasmo: i modelli di elaborazione del linguaggio faticano a interpretare l'umorismo impassibile o il sarcasmo, rischiando talvolta di evidenziare battute satiriche presentandole come dichiarazioni letterali.
- Voci sovrapposte e rientro audio (bleed): quando due ospiti parlano contemporaneamente in microfoni non isolati, i modelli di tracciamento degli speaker possono andare in confusione, facendo rimbalzare freneticamente l'inquadratura da un soggetto all'altro.
- Segnali non verbali fraintesi: una pausa a effetto con intento comico o drammatico può essere scambiata dagli algoritmi di rilevamento del silenzio per un tempo morto, generando un taglio innaturale a metà frase.
Comprendere questi limiti tecnici chiarisce perché una bozza generata dagli algoritmi vada considerata come una base di partenza, non come un prodotto definitivo pronto per la pubblicazione.
Revisione human-in-the-loop: perfezionare le bozze dell'AI prima di esportare e pubblicare
Trasformare una prima bozza in uno Short ad alto tasso di fidelizzazione richiede un passaggio di revisione editoriale manuale. Unendo la velocità computazionale degli algoritmi al discernimento umano, i creator possono ottenere risultati impeccabili in una frazione del tempo richiesto dal montaggio manuale tradizionale.
Checklist di controllo pre-pubblicazione
Prima di esportare le clip dal flusso di lavoro che converte video YouTube in Shorts con AI, verifica questi quattro aspetti tecnici:
- Verifica del contesto: la clip risulta perfettamente comprensibile per qualcuno che non ha mai visto il tuo canale?
- Regolazione dei margini: estendi l'inizio o la fine della clip di 1–2 secondi se l'algoritmo ha tagliato un respiro o una frase introduttiva.
- Integrità dell'inquadratura visiva: accertati che movimenti rapidi delle mani o cambi di postura non abbiano causato movimenti a scatto dell'inquadratura.
- Precisione del testo e termini tecnici: controlla terminologia specialistica, nomi di brand o espressioni colloquiali che il riconoscimento vocale automatico potrebbe aver trascritto solo foneticamente.
L'impiego di piattaforme specializzate come ClipFlap consente ai creator di sfruttare la selezione degli highlight basata sul testo, il reframing automatico e i sottotitoli dinamici sincronizzati, mantenendo al contempo il pieno controllo sulla timeline per calibrare i margini temporali, perfezionare la grafica dei testi e regolare la posizione dei parlanti prima della pubblicazione.
Domande frequenti
In che modo un AI clip maker identifica quali parti di un video di YouTube vale la pena ritagliare?
Gli strumenti basati sull'AI analizzano i video sincronizzando le trascrizioni vocali con l'energia dell'audio e i dati visivi. I modelli di elaborazione del linguaggio naturale individuano confini tematici, ganci narrativi ed esiti conclusivi, mentre i modelli acustici esaminano variazioni di volume, risate o pause enfatiche per isolare momenti di dialogo completi e autosufficienti.
Perché i sottotitoli a tempo di parola sono più efficaci per le clip brevi rispetto ai sottotitoli classici?
I sottotitoli a tempo di parola mostrano testi cinetici ed evidenziati sincronizzati al millisecondo con ciascuna parola pronunciata. Questo formato rafforza il ritmo del discorso, mantiene l'attenzione dello spettatore ancorata al centro del video verticale e si adatta alla visione senza audio senza appesantire lo schermo con blocchi di testo su più righe.
I generatori di clip AI riescono a seguire con precisione più interlocutori durante un podcast?
Sì, i moderni generatori di clip combinano la diarizzazione audio con il tracciamento facciale per rilevare chi sta parlando e adattare l'inquadratura di conseguenza. I sistemi più avanzati possono alternare inquadrature singole del parlante attivo a layout a schermo diviso (split-screen) quando entrambi i partecipanti interagiscono.
Perché è consigliabile una revisione manuale prima di pubblicare le clip create dall'AI?
I sistemi automatici possono fraintendere il sarcasmo, troncare contesti necessari o trascrivere erroneamente nomi di marchi e termini tecnici. Una rapida revisione editoriale assicura che il gancio sia incisivo, l'inquadratura stabile e il messaggio fedele all'intento del creator.
Vuoi ottimizzare il tuo flusso di repurposing video? Scopri come il generatore di clip AI analizza il materiale di partenza, automatizza il reframing verticale e crea sottotitoli sincronizzati, lasciandoti sempre il pieno controllo editoriale.
Provalo con la tua puntata
10 minuti di elaborazione gratis, senza carta di credito. La durata dipende dalla lunghezza del video e dalla coda; controlla ogni clip prima di pubblicarla.