Como os Geradores de Cortes com IA Processam, Enquadram e Legendam Vídeos do YouTube
Descubra como um gerador de cortes com IA para YouTube analisa transcrições, rastreia pessoas, reenquadra em 9:16 e sincroniza legendas palavra por
Atualizado em Por ClipFlap editorial team
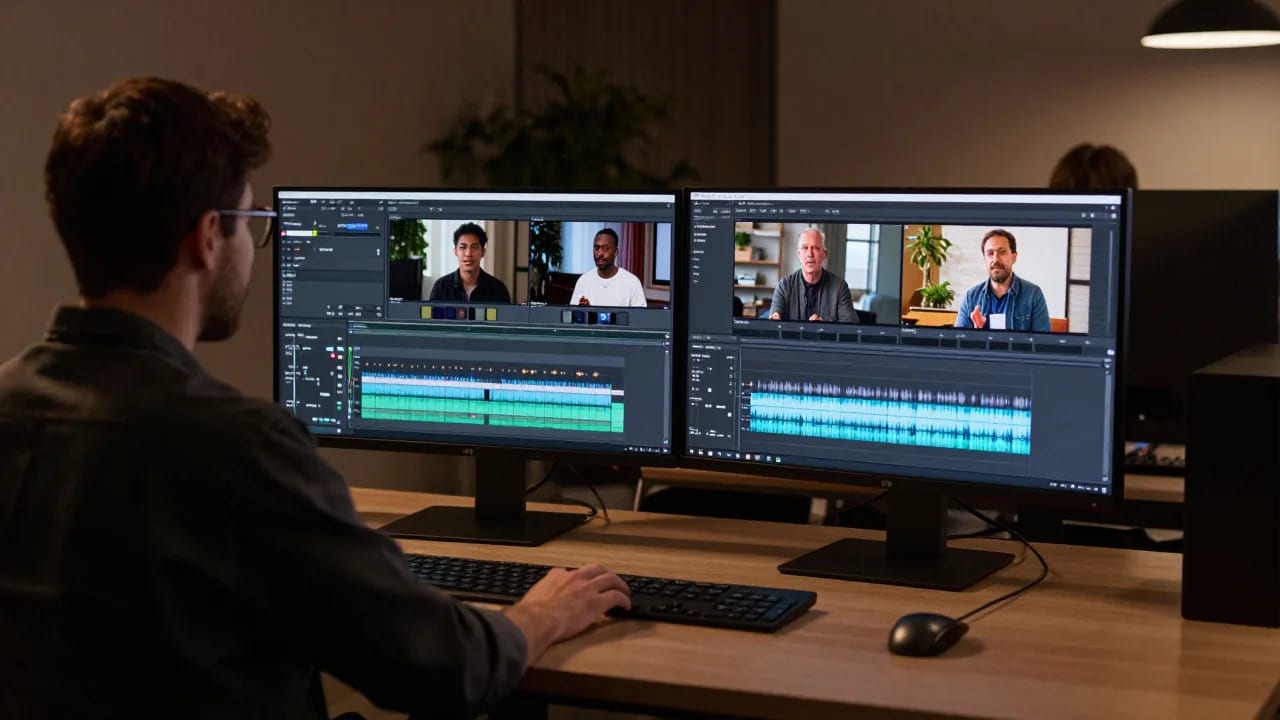
Reaproveitar vídeos longos em shorts verticais tornou-se uma estratégia indispensável de distribuição, mas varrer manualmente timelines de várias horas exige tempo e concentração consideráveis. Um gerador de cortes com IA para YouTube acelera esse fluxo de trabalho, transformando entrevistas gravadas, podcasts e palestras em segmentos curtos, objetivos e estruturados. Em vez de depender de suposições ou cortes aleatórios, esses sistemas combinam transcrição automatizada, rastreamento visual e análise acústica para isolar momentos com início, meio e fim.
Compreender o pipeline técnico por trás desse processo ajuda editores de vídeo, podcasters e equipes de conteúdo a avaliar o real potencial das ferramentas automatizadas — e a identificar exatamente onde o olhar editorial humano continua indispensável.
O Pipeline em Múltiplas Etapas: Como a IA Ingere e Analisa Vídeos Longos do YouTube
A automação da transição de um vídeo horizontal do YouTube para um corte vertical não se resume a um único cálculo. O processo exige uma sequência coordenada de modelos de aprendizado de máquina trabalhando em conjunto sobre fluxos de áudio e dados visuais.
Assim que o arquivo ou link do vídeo é importado, o sistema decompõe o contêiner em canais independentes de áudio e vídeo:
- Desmultiplexação de Áudio: A faixa de áudio é isolada e normalizada para remover ruídos de fundo e nivelar a clareza da voz.
- Transcrição de Voz para Texto: Um modelo de reconhecimento de fala converte os diálogos em um fluxo de texto com marcações temporais no nível de milissegundos.
- Análise da Forma de Onda Sonora: Envelopes de volume, pausas, variações de entonação e picos acústicos repentinos são indexados junto ao texto transcrito.
- Decodificação por Visão Computacional: A faixa de vídeo é amostrada para mapear mudanças de cena, cortes de câmera e pontos de referência facial.
Com todas essas camadas sincronizadas, uma ferramenta de recorte de vídeo com IA consegue interpretar a estrutura narrativa do conteúdo, deixando de tratar o vídeo apenas como uma sequência de pixels estáticos.
Análise Baseada em Transcrição: Como os Algoritmos Detectam Ganchos e Arcos Narrativos Coesos
Identificar um bom clipe curto vai muito além de detectar momentos com falas mais enérgicas; requer isolar uma unidade narrativa completa. Conversas longas costumam apresentar divagações, interrupções e referências contextuais que perdem todo o sentido quando publicadas isoladamente nas redes sociais.
Detecção de Limites Semânticos
Por meio do processamento de linguagem natural (PLN), o sistema analisa a transcrição para identificar onde ideias individuais começam e terminam. O algoritmo agrupa as frases em blocos temáticos com base na proximidade semântica entre termos adjacentes. Sempre que o tópico muda de forma substancial, um marcador de limite é registrado.
Identificação de Ganchos e Desfechos
Para que a detecção automática de destaques funcione com precisão, o algoritmo avalia os trechos candidatos a partir de critérios de coesão narrativa:
- O Gancho Inicial: O sistema busca afirmações declarativas de impacto, perguntas provocativas ou aberturas temáticas fortes logo no início do bloco.
- Completude Sintática: Segmentos com excesso de pronomes sem referência clara (como "conforme explicamos antes") recebem notas menores, já que não funcionam de maneira autônoma.
- O Clímax ou Desfecho: O algoritmo rastreia conclusões conceituais, sínteses ou frases de efeito cômico, muitas vezes confirmadas pela análise de áudio que indica risadas ou falas enfáticas.
Com essa triagem baseada em transcrição, o software localiza trechos com duração entre 30 e 90 segundos que possuem coerência própria, sem exigir que o espectador já conheça o conteúdo prévio do canal.
Visão Computacional e Reenquadramento: Convertendo Vídeos Horizontais para o Formato Vertical 9:16
A maior parte das gravações do YouTube é produzida no formato horizontal 16:9. Adaptar essas gravações para o padrão vertical exige um reenquadramento inteligente, e não um simples corte central estático, que frequentemente deixa quem está falando fora do quadro.
Detecção Facial e Diarização de Locutores
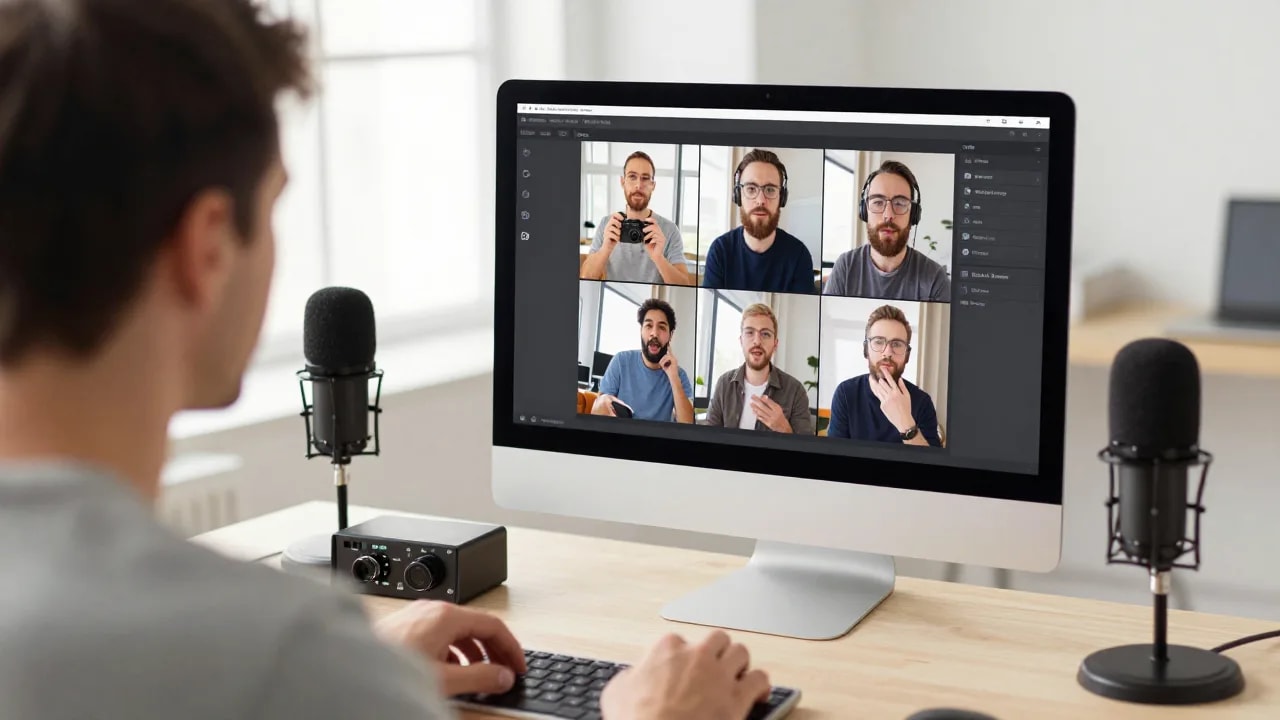
Para preservar o ponto focal na tela, o sistema alia o reconhecimento facial por visão computacional à diarização de áudio. A diarização categoriza "quem falou o quê e quando" com base no perfil de frequência da voz. Assim que o Interlocutor A começa a falar, a visão computacional localiza sua caixa delimitadora (bounding box) e alinha a câmera virtual diretamente ao seu rosto.
Movimentação Dinâmica e Suavização de Câmera
Quando uma pessoa se desloca pelo cenário ou gesticula, a visão computacional monitora a caixa delimitadora continuamente. Em vez de executar saltos visuais bruscos — que geram um aspecto robótico e desconfortável —, o software aplica curvas de atenuação matemática para simular o movimento fluido de um operador de câmera profissional.
Layouts para Múltiplos Interlocutores
Em podcasts com dois participantes ou entrevistas com convidados, o reenquadramento precisa ser ainda mais dinâmico. Diversos criadores adotam um fluxo de transformação de podcasts em cortes que alterna entre telas divididas (mostrando apresentador e convidado simultaneamente) e planos focados em quem estiver com a palavra, respeitando o ritmo e eventuais sobreposições de conversa.
Geração de Legendas Sincronizadas Palavra por Palavra: Alinhamento de Fonemas e Tipografia Visual
As legendas tornaram-se um elemento fundamental nos feeds verticais, onde muitos usuários consomem vídeos sem som. As legendas tradicionais — com blocos estáticos de duas linhas na base da tela — vêm sendo amplamente substituídas por legendas cinéticas e dinâmicas.
Alinhamento Acústico Forçado
A geração de legendas sincronizadas palavra por palavra por IA depende do alinhamento acústico forçado (forced alignment). O motor de transcrição decompõe cada palavra em seus fonemas correspondentes e os associa aos pontos exatos da forma de onda do áudio em milissegundos. Isso assegura que o texto apareça no ritmo perfeito da fala.
Tipografia Visual e Ritmo de Leitura
Com as marcações temporais definidas, o motor de renderização aplica estilos tipográficos voltados à retenção:
- Exibição de blocos curtos e fáceis de assimilar (de uma a três palavras por vez) para conduzir os olhos do espectador.
- Destaque na palavra falada no momento por meio de cores em contraste ou sutis animações de escala.
- Respeito às áreas de respiro e zonas de segurança verticais, evitando que botões de interação, nomes de perfis ou caixas de comentários cubram o texto.
Limitações Técnicas: Onde a Seleção Automática de Momentos Pode Falhar
Apesar de absorver a maior parte do trabalho braçal, os modelos de aprendizado de máquina não possuem discernimento humano real. Criadores que dependem exclusivamente de automação sem revisão enfrentam alguns problemas recorrentes:
- Cortes Fora de Contexto: O algoritmo pode isolar uma frase marcante, mas suprimir acidentalmente uma ressalva essencial dita logo antes.
- Ironia e Sarcasmo: Modelos de linguagem natural costumam ter dificuldade para decodificar humor seco ou sarcasmo, podendo classificar comentários irônicos como informações sérias.
- Falas Simultâneas e Vazamento de Som: Quando dois participantes falam ao mesmo tempo sem isolamento acústico adequado, os rastreadores de locutor podem oscilar de forma desordenada entre os rostos.
- Interpretação Errônea de Pausas: Um silêncio intencional usado para ênfase dramática ou humorística pode ser lido pelos detectores de silêncio como tempo morto, gerando cortes abruptos.
Compreender essas restrições técnicas evidencia por que o material gerado pela IA deve ser tratado como um rascunho de alta qualidade, e não como uma versão definitiva.
Revisão com Supervisão Humana: Refinando Rascunhos da IA Antes de Exportar e Publicar
Transformar um rascunho automatizado em um corte com excelente retenção requer sensibilidade editorial. Combinando a agilidade do algoritmo com o critério humano, criadores conseguem produzir materiais impecáveis em uma fração do tempo habitual.
Checklist de Qualidade Pré-Publicação
Antes de exportar seus conteúdos a partir do fluxo de geração de shorts com IA, avalie quatro pontos centrais:
- Coerência de Contexto: O clipe é perfeitamente compreensível para alguém que nunca teve contato prévio com o canal?
- Ajuste de Margens: Amplie o início ou o fim do trecho em 1 a 2 segundos caso a ferramenta tenha cortado uma respiração ou introdução.
- Estabilidade do Enquadramento: Verifique se movimentos rápidos com os braços ou pequenas trocas de postura não provocaram pulos visuais no reenquadramento.
- Revisão de Termos e Jargões: Confira nomes de marcas, termos técnicos e expressões informais que o reconhecimento de voz possa ter transcrito de forma imprecisa.
Plataformas especializadas como o ClipFlap viabilizam esse fluxo ao combinar seleção inteligente de destaques, reenquadramento dinâmico e legendas sincronizadas palavra por palavra, preservando o controle total da timeline para ajustes finos de cortes, tipografia e enquadramento antes da postagem.
Perguntas Frequentes
Como um gerador de cortes com IA identifica quais partes de um vídeo do YouTube valem a pena cortar?
As ferramentas de IA sincronizam as transcrições do diálogo com métricas visuais e variações na energia do áudio. Modelos de processamento de linguagem natural mapeiam limites temáticos, ganchos e conclusões lógicas, enquanto modelos acústicos analisam subidas de tom, gargalhadas ou pausas enfáticas para isolar blocos de conversa completos.
Por que legendas sincronizadas palavra por palavra funcionam melhor em vídeos curtos do que legendas tradicionais?
Essas legendas mostram termos destacados exatamente no instante em que são ditos, reforçando o ritmo da fala e mantendo a atenção no centro do enquadramento vertical. Além de facilitarem o consumo com o áudio desativado, elas evitam que blocos estáticos de texto ocupem espaço excessivo na tela.
Os geradores de cortes com IA conseguem acompanhar múltiplos interlocutores em um podcast com precisão?
Sim. As soluções modernas utilizam a diarização de áudio em conjunto com o rastreamento facial para identificar o locutor do momento e ajustar a visualização. Softwares mais avançados conseguem ainda intercalar planos individuais com visões divididas na vertical quando os participantes dialogam ao mesmo tempo.
Por que a revisão manual é recomendada antes de publicar cortes gerados por IA?
A automação pode deixar passar ironias, suprimir contextos importantes ou errar a grafia de termos técnicos e nomes de marcas. Uma rápida checagem editorial garante ganchos precisos, enquadramento estável e fidelidade à proposta original do criador.
Quer simplificar a forma de reaproveitar seus vídeos? Conheça como o gerador de cortes com IA analisa suas gravações, automatiza o reenquadramento para o formato vertical e cria legendas perfeitamente sincronizadas, mantendo você no comando de cada decisão editorial.
Teste com o seu próprio episódio
10 minutos de processamento grátis, sem cartão. O tempo varia com a duração do vídeo e a fila; revise cada clipe antes de publicar.